Введение
Учебный текст создается в интересах обучения. Его назначение заключается в том, чтобы обеспечить передачу сведений о конкретной предметной области и способствовать организации учебного процесса в интересах усвоения учебного материала. В него обычно включают определения, классификации, правила, теоремы, алгоритмы, примеры, пояснения, контрольные вопросы и задания. Эти элементы имеют разную функцию, но благодаря структуре своего построения в совокупности отображают заданную автором траекторию изложения учебного текста.
Применение современных информационных технологий для анализа и содержательного оперирования представленными в вербальном виде текстами (кроме собственно их чтения) весьма затруднено. В этой связи представляется актуальной следующая задача.
Задан представленный в вербальной форме исходный учебный текст. Требуется трансформировать его в формализованный аналог, в максимальной мере сохраняющий его учебно-методическое содержание и структуру. Это, в частности, означает, что он должен передавать структуру учебного материала: какие объекты и как вводятся, какие свойства им приписаны, какие действия и как с ними выполняются, какие результаты получаются, а также какие зависимости и в каком порядке между этими компонентами в учебном материале установлены.
Теоретическая основа
Задача формализации вербальных текстов не нова, ее постановка восходит к работам А.П. Ершова (Ершов, 1985). Однако она до сих пор далека от удовлетворительного решения. Более того, имеют место достаточно убедительные доводы в пользу следующего тезиса: разработка методов формализации произвольных вербальных текстов с передачей их содержания в обозримом будущем, скорее всего, невозможна (Walter et al., 2017). Вместе с тем по мере развития информационных технологий потребность в разработке соответствующих средств постоянно повышается, о чем свидетельствуют многочисленные исследования в этом направлении (Большакова и др., 2017; Воронов, 2022; Зацман, 2009; Lochter et al., 2018; Пешкова, 2015; Пименов, Воронов, 2021).
В сложившейся ситуации стали разрабатываться подходы к решению такого рода задач применительно к особым видам текстов. Так, перспективной представляется разработка методов формализации текстов, обладающих достаточной степенью регулятивности.
К регулятивным (вносящим порядок) относят тексты, которые по своему назначению и построению явно ориентированы на управление интерпретационной, следовательно, и поведенческой деятельностью читателя (Сидоров, 1987). Важно отметить, что регулятивный текст обладает такими ярко выраженными качествами, как информативность, структурность, интегративность, целенаправленность и др. (Болотнова, 2011, с. 34). Подчеркнем, что центральная функция регулятивных текстов заключается не только в передаче сообщений, в которых задаются сущности, условия, порядок выполнения операций и фиксируются результаты, но и в ориентации читателя на его последующие действия; в такие тексты в большом количестве включены глагольные конструкции, выражающие повеление (императивы). Наиболее характерными представителями регулятивных текстов являются приказы, указания, инструкции, планы (Хорохордина, 2013). Ярко выражены такого рода свойства в описаниях технологий (Воронов, 2023).
Важно отметить, что регулятивным текстам присущи: логичность изложения, отсутствие иносказаний, минимум эмоциональной окраски и образности, при широком использовании специфической, предметно ориентированной терминологии. Становится ясно, что существенно выражены свойства регулятивности и у учебных текстов. Достаточно отметить, что они по самой своей сути ориентированы на целеизъявление автора направить мысли и действия обучаемого на достижение по вполне конкретной логике конкретных целей. Существенно, что учебный материал излагается, как правило, во вполне определенном порядке. Так, фрагменты знаний вводятся последовательно и методично с опорой на уже введенные (или полагаемые априори известными) сущности. В этом плане учебный текст в известной мере может рассматриваться как представленный в словесном виде алгоритм. По нашему мнению, именно наличие свойств регулятивности открывает возможности в достаточной мере успешного решения задачи формализации такого рода текстов в виде графов (Qu et al., 2024).
Подчеркнем: в поставленной задаче важнейшим является требование в максимальной степени сохранить в модели содержание именно данного исходного вербального текста, не допуская никакой его корректуры. В этой связи для ее решения представляется полезным привлечь некоторые результаты исследований лингвистов. В регулятивных текстах ключевое положение занимает отображение описываемой событийности. В этой связи следует обратиться к понятию «денотативная ситуация», которая представляет собой отображение текстового фрагмента, связанного с определенным событием. Как правило, таким фрагментом выступает предложение, в котором производится описание этого события.
С лингвистических позиций денотативная структура представляет собой определенное множество денотатов и отношений между ними (при ведущей роли последних). Следовательно, можно сказать, что содержание исходного текста заключено, главным образом, в его денотативных ситуациях. В этой связи ключевым может стать решение вопроса формализации отдельных денотативных ситуаций, каждая из которых в регулятивных текстах обычно представлена в обособленных предложениях.
В лингвистике исследование организации предложения с целью выявления его семантики осуществляется в рамках семантического (функционального) синтаксиса. При этом делаются попытки выявления смысловой организации предложения. Вместе с тем «пока нет четко сформулированных критериев выделения семантических моделей предложения и его компонентов» (Галимова, 2021, с. 255). Однако доказано, что содержание данного предложения может быть отображено в формализованной структуре (семантической конфигурации), образованной соответствующим множеством денотатов и отношений между ними.
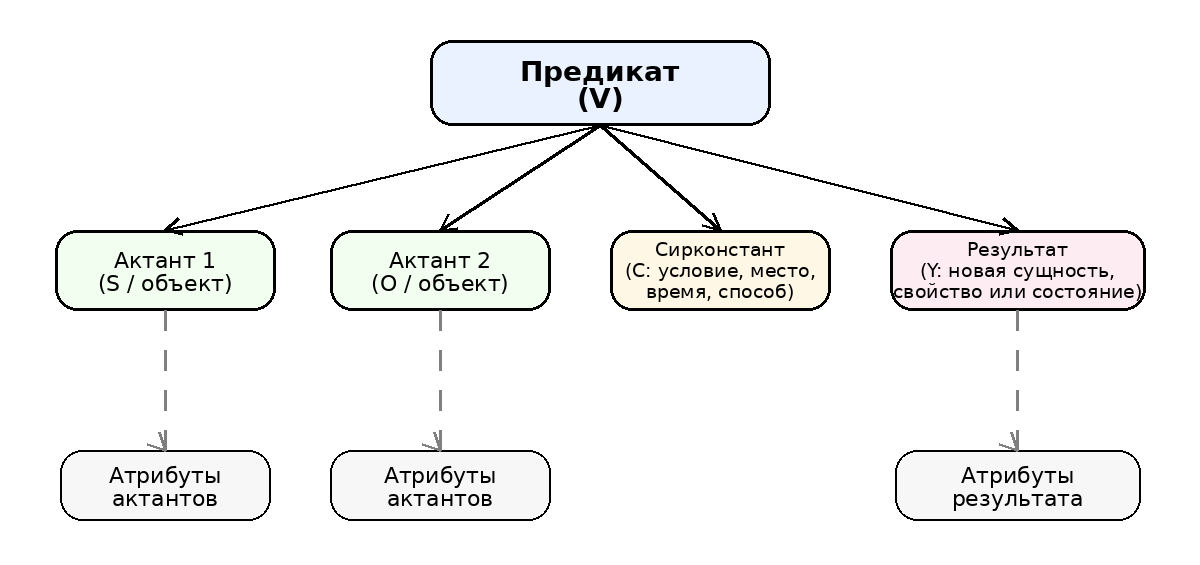
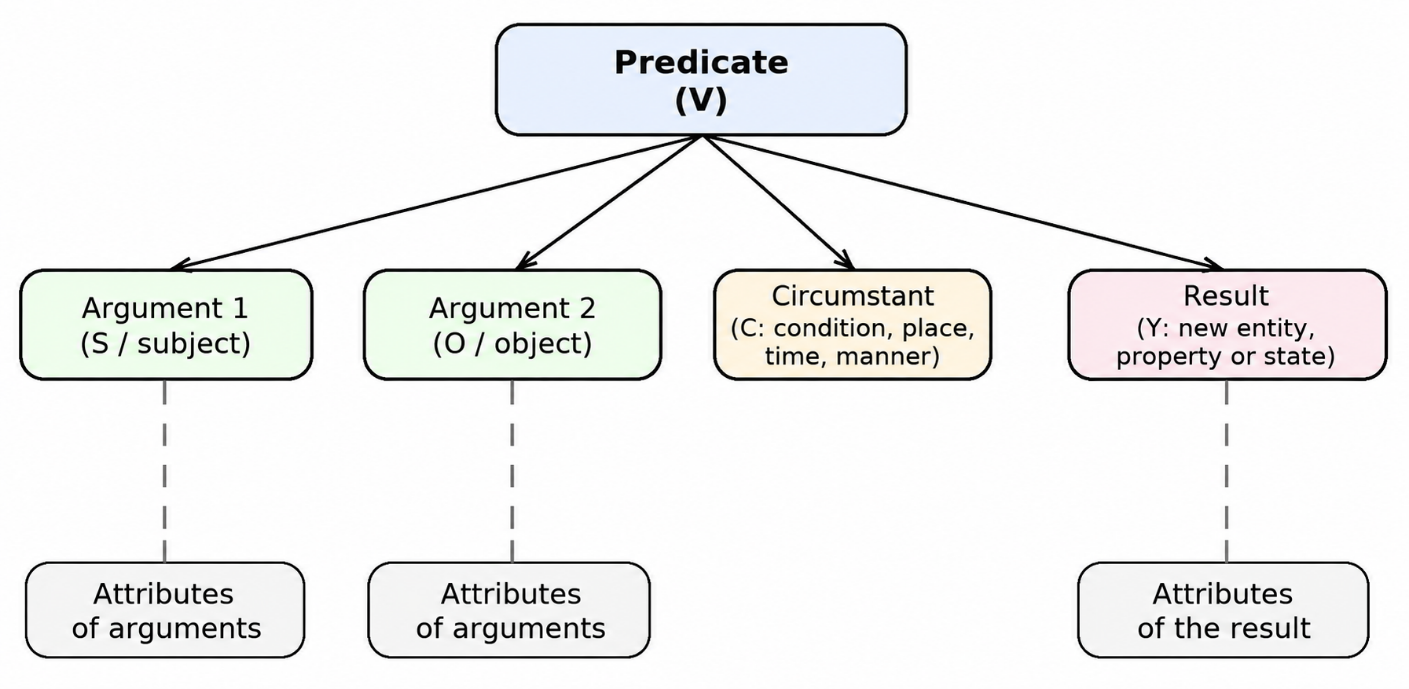
При этом основным предметом рассмотрения выступает пропозиция, как языковое воплощение описываемого события, заключенное в семантической структуре предложения. По существу, пропозиция представляет собой отраженную модель описываемой в предложении ситуации (Арутюнова, 1976, с. 7). Ее составляющие ⎼ предикат, актанты, сирконстанты и связывающие их отношения. Подчеркнем, основная семантическая роль в предложении, согласно вербоцентрической теории Теньера, принадлежит предикату, как вершине пропозиции.
Согласно этой теории, предикат (с позиции лингвистики ⎼ сказуемое) является центральным и единственным главным компонентом пропозиции. Чаще всего он выражен глаголом, иногда причастием, деепричастием или отглагольными существительными словами категории состояния. Для нас важно то, что именно предикат, обозначая действие, состояние, свойство или качество предмета, определяет места и роль остальных участников описания ситуации.
Актанты ⎼ это имена действующих лиц данной пропозиции. В их число входят подлежащее и дополнения. Как элементы событийной пропозиции они заложены в ролевую структуру сказуемого (входят в его базовую валентность). Описание актантов обычно дополняют и уточняют соответствующие для каждого из них атрибуты.
Для отражения факультативных валентностей использованного глагола в предложении могут присутствовать функциональные единицы, называемые сирконстантами (адъюнктами). В содержательном аспекте это обстоятельства или определения, как правило соответствующие времени, месту и способу описываемого в предложении действия.
В качестве результатов описываемого события выступает вводимая новая сущность, описание ее свойств или новое состояние участников описываемого события.
Начало научного рассмотрения проблематики формализации семантики текста связано, пожалуй, с работами А.И. Новикова (Новиков, 1983), в которых, в частности, высказана идея отображения денотативного уровня текста в виде денотатного графа, который трактуется как «свернутое эксплицитное отображение структуры содержания текста, которой могут соответствовать различные языковые формы» (Новиков, Нестерова, 1991, с. 61). Предлагаемые в этих работах подходы построения денотатного графа базируются на иерархическом выделении так называемых «ключевых» компонентов, подтем и раскрывающих их содержание субподтем. Иначе говоря, элементами формируемого графа выступают самые различные фрагменты учебного текста, часто входящие в состав его оглавления. Такой подход активно используется преподавательским составом, поскольку, отражая в целом логику изложения учебного материала, способствует организации работы и обучающего, и обучаемого.
Исследования показывают, что успех поставленной нами задачи в существенной степени зависит от способа членения текста на составляющие единицы (Пименов, Воронов, 2021). Фрагменты, на которые вполне обоснованно разбивается учебный текст с педагогических позиций, не могут рассматриваться в качестве неделимых единиц (учебных квантов), ибо представляют собой, как правило, несколько предложений. Отдельное же предложение — это связанная по смыслу группа слов, выражающая законченную мысль, в данном контексте ключевое значение в этом определении имеет термин «законченную мысль». Именно в этой связи в качестве содержательной единицы учебного текста примем его отдельное предложение.
В учебных текстах практически каждое предложение несет на содержательном уровне конкретную единицу учебной информации, отображая введение новой сущности, ее свойств или процедуру изменения состояния рассматриваемого объекта. Логически упорядоченная последовательность такого рода содержательных предложений и передает содержание учебного текста в целом.
Вышеизложенное позволяет разработать конструктивный метод формализации предложений учебного текста.
Результаты
Предлагается метод построения формальной модели, отображающей содержание и логику данного учебного текста, осуществляемый в виде конструктивного процесса. Этот процесс разобьем на два этапа. На первом в автоматизированном режиме каждое предложение (в строгом порядке их следования по тексту) отображается в соответствующую совокупность фреймов, которая трактуется как граф предложения. На втором в автоматическом режиме построенные графы предложений объединяются в единый граф, который и представляет собой формальную модель рассматриваемого текста.
Такого рода алгоритм представим в следующем виде.
где
-
· – номер присутствующего в данном предложении предиката. В предложении (например, в сложном предложении) может быть более одного сказуемого, поэтому b (
-
· имя предиката (состоит из слов, отображающих в -м предложении описание действия)
-
· – множество относящихся к данному предикату номеров и соответствующих имен сирконстантов (слов, указывающих на время, место, образ действия и другие обстоятельства ситуации). Их у предиката может быть несколько, поэтому
-
· – файл исходного текста предложения (выполняет служебную роль).
где
-
· – номер очередного актора. В каждом действии обычно участвует несколько акторов, поэтому ( ;
-
· – имя актора ;
-
· множество пар номеров и имен атрибутов, дополняющих и уточняющих описание соответствующего актанта. При каждом актанте может находиться по несколько атрибутов, поэтому (
где
-
· – номер результата. В каждом действии могут фиксироваться несколько результатов, например, когда описаны новые состояния нескольких сущностей, поэтому ( ;
-
· – имя результата (слова, описывающие в данном предложении результат под номером
-
· множество пар номеров и имен результатов, дополняющих и уточняющих описание соответствующего результата. В предложении может фиксироваться несколько результатов, поэтому (
3.В автоматизированном режиме осуществляется заполнение этих фреймов, и они превращаются в группу фреймов-экземпляров, в которых зафиксировано содержание и структура соответствующего предложения.
KVᵢ = ⟨Aᵢ, Dᵢ, Yᵢ⟩
Для выявления этого соответствия реализуется следующая процедура:
G = {KVᵢ} ∪ MG
вершины которого соответствуют элементам множества
, а ребрам — элементы матрицы
Обсуждение результатов
Полученные результаты подтверждают перспективность перехода от общей задачи формализации произвольных текстов к работе с регулятивными текстами. В отличие от методов построения денотатного графа на основе крупных тематических фрагментов (Новиков, 1983; Новиков, Нестерова, 1991), предлагаемый подход использует предложение как минимальную содержательную единицу. Это позволяет сохранять порядок введения понятий, отношения между содержательными составляющими предложения и прослеживать связи между результатами одних предложений и акторами последующих. По сравнению с обобщенными подходами к образовательным графам знаний (Qu et al., 2024), метод ориентирован не на интеграцию внешних ресурсов, а на формальное воспроизведение логики конкретного учебного текста.
В результате применения изложенного метода появляется возможность построения ориентированного графа, представляющего собой формальную модель рассматриваемого учебного текста в целом. Каждый его подграф отображает содержание отдельного предложения, выступающего в качестве кванта исходного учебного текста. Практически в каждом предложении текста вводится новая сущность или процедура, выполнение которой изменяет состояние соответствующей группы сущностей. Эта информация фиксируется в ряде фреймов, причем в такой форме, чтобы имелась возможность адекватного воспроизведения содержания, передаваемого данным предложением. Ключевым моментом в достижении этого эффекта является декомпозиция предложения, следующая его семантической структуре (рис. 1).
Для подтверждения работоспособности разработанного метода были проведены эксперименты по сравнению содержания исходного и восстановленного из модели текстов. Для этого были выбраны фрагменты текста из известного учебника «Математика и информатика» (Турецкий, 2002). Экспертиза признала высокий уровень совпадения содержания сравниваемых текстов и практически адекватное совпадение передаваемого ими содержания.
Все включенные в подграфы содержательно связаны, причем следуя точно по той же логике, что и содержательные элементы исходного текста. Поскольку построенный граф адекватно отображает установленные в тексте между этими элементами отношения, открываются перспективы построения компьютерных методик для эффективного решения широкого ряда прикладных вопросов. Заметим, что графовые модели очень удобны для построения соответствующих программных продуктов.
Перспективы использования метода
Построенный граф, отображающий содержание учебного текста, — это не конечный продукт, а основа для разработки множества приложений. Вот только некоторые из них.
Важным свойством учебного текста является полнота вводимых сущностей и порядок их введения. Критерием полноты вводимых сущностей может выступать результат проверки связности построенного графа GT.
Может быть поставлен и решен вопрос об интенсивности использования в данном учебном материале той или иной сущности; на базе выбранной метрики можно оценить ее «важность» и вынести более обоснованные учебно-методические рекомендации по изучению данного учебного курса.
На многие вопросы, связанные с оценкой учебного текста, можно найти ответы, используя результаты теории оценки целостности графа (Быкова, 2014). В частности, оценивая степень возможного «повреждения графа», можно судить об уровне влияния фактов невведения в учебный текст предметных сущностей и выявлять другие факторы «повреждения» логики изложения учебного материала.
В открытом доступе имеются библиотеки компьютерных процедур, обеспечивающих решение широкого спектра так называемых «задач на графах». Среди них важное место занимают задачи «построения путей на графе». Такого рода инструменты активно используются при построении средств поддержки процессов самоподготовки студентов. В ходе этих процессов часто возникают ситуации, когда студент испытывает затруднения при выполнении конкретного учебного задания. При этом обычно возникает вопрос о том, что лежит в основе возникших трудностей именно для данного студента, причем «здесь и сейчас». Наличие возможности построения «обратных» путей от данной учебной ситуации к ее истокам, причем строго следуя логике изложения учебного материала в данном учебном тексте и учитывая логику использования «предпосылок», позволяет найти причины возникших затруднений и сформировать актуальный для данной ситуации вариант адекватных рекомендаций обучающемуся.
Разработанный метод позволяет строить методики формирования родовидовой структуры используемых в данном учебном материале сущностей и на их основе разрабатывать программные продукты, реализующие эти методики для конструирования таксономической онтологии рассматриваемой предметной области (Маторин, Михелев, 2021).
Заключение
Изложенный метод построения модели, отображающей содержание учебного текста, базируется на результатах семантической лингвистики, методах формирования баз знаний и идеях конструктивной математики. В результате его применения представленный в вербальной форме учебный материал отображается в ориентированный граф, в котором сохраняется содержание и логика построения исходного учебного материала.
Благодаря этому сформированный граф может использоваться в качестве базы для создания ряда качественно новых программных средств. Так, в результате анализа построенной для данного учебного текста модели может быть разработана онтология вводимых понятий, произведена оценка содержательно-логической связности представленного текста, выявлены случаи нарушения логики изложения учебного материала и др.
Если на основе данного учебного материала построена программа освоения соответствующей учебной дисциплины, удобно строить средства компьютерной поддержки процессов подготовки контрольно-измерительных материалов, проведения собственно контроля и самоподготовки конкретного обучаемого.
Объединение моделей, построенных для совокупности книг по данной предметной области, открывает возможность построения открытой для наращивания соответствующей единой базы знаний, более обоснованно формировать рекомендации по методическому обеспечению данной учебной дисциплины и даже образовательной программы в целом.
Ограничения
Несомненно, предложенный метод имеет ряд ограничений. Во-первых, желательна высокая регулятивность текста, в первую очередь его логичность, терминологическая устойчивость, минимальная образность и отсутствие омонимии. В этой связи наиболее подходящими являются учебные материалы для математики, естественно-научных и профильных дисциплин инженерного и технологического направления.
Во-вторых, эффективность метода существенно зависит от правильности интерпретации предикатно-актантной структуры предложения, ибо корректное определение того, какие элементы участвуют в описываемой ситуации и какую роль они в ней играют, обеспечивает уровень адекватности отображения семантики данного исходного предложения при его формализации.
В-третьих, метод описан для учебных текстов, написанных на русском языке, и, по-видимому, требует адаптации к особенностям различного, вообще говоря, литературного почерка авторов, а также при рассмотрении переводных текстов.