Введение
Выбор аппаратной платформы для исполнения современных детекторов на периферийных устройствах сводится к компромиссу между пропускной способностью, задержкой, точностью и сложностью интеграции. На момент написания статьи два решения претендуют на роль массового вычислительного ядра в задачах реального времени: одноплатный компьютер Orange Pi 5(Orange Pi, 2023) с интегрированным NPU на базе Rockchip RK3588 (до 6 TOPS, INT8) и связка Raspberry Pi 4 Model B (Raspberry Pi OS, n.d.) с внешним USB‑ускорителем Google Coral (4 TOPS, INT8). Обе платформы предполагают исполнение нейросетевого вывода вне центрального процессора, однако используют принципиально различные программные экосистемы — RKNN и TensorFlow Lite делегат Edge TPU соответственно.
Цель настоящей работы — прямое экспериментальное сравнение указанных конфигураций при выполнении задачи детекции объектов моделью YOLO11n (Jocher, 2024). Сравнение проводится по трём ключевым метрикам: точность (mAP@0,5 на стандартном валидационном подмножестве COCO (COCO Dataset, n.d.)), частота кадров (FPS) и полная сквозная задержка (от захвата изображения до получения координат). Для обеих платформ модель конвертируется из общего исходного файла PyTorch в целевые форматы (RKNN и TFLite) с применением рекомендованных производителем инструментов, без внесения структурных изменений в вычислительный граф. Измерения выполняются при идентичном входном разрешении (640×640) и одинаковом наборе тестовых изображений, что исключает влияние внешних факторов.
Данная работа предъявляет поэтапную методику портирования, фиксирует конфигурации окружений и версии библиотек, приводит методику измерения задержек и подробные таблицы результатов. Итоговый вывод содержит рекомендации по выбору платформы для практических развертываний с учетом не только пиковых цифр, но и удобства сопровождения, доступности инструментов и стабильности работы в длительных нагрузочных тестах.
Обзор модели нейросети
В качестве единой модели для экспериментов выбрана YOLO11n (Jocher, 2024) — самая лёгкая версия новейшего семейства детекторов Ultralytics (Ultralytics Documentation, n.d.), специально оптимизированная для исполнения на периферийных устройствах с аппаратными ускорителями. При всего 2,6 миллионах параметров и вычислительной сложности порядка 6,5 GFLOPS (для разрешения 640×640) модель сохраняет конкурентоспособную точность, что делает её идеальным кандидатом для развертывания на платформах с ограниченными ресурсами. Архитектура наследует сильные стороны предшественников: облегчённый бэкбон на основе CSPNet с эффективными блоками C3k2, многоуровневую пирамиду признаков PAN с улучшенной агрегацией контекста и стандартные сверточные блоки, лишённые вычислительно избыточных трансформерных элементов. По сравнению с YOLOv8 модель демонстрирует рост mAP на 0,5–1,0% при сопоставимых вычислительных затратах, а по сравнению с YOLOv10 — более предсказуемую конвертацию в форматы нейросетевых ускорителей благодаря отсутствию операций, плохо поддержанных во встраиваемых runtime-библиотеках (в частности, устранены некоторые экзотические функции активации и нормализации, характерные для десятой версии).
Ключевое преимущество YOLO11n в контексте данной работы — высокая совместимость с обоими целевыми инструментальными цепочками. Модель использует хорошо известный набор операций, полностью покрываемый как RKNN-Toolkit2 (для Rockchip NPU (Rockchip Electronics Co., Ltd., 2022)), так и конвертером TensorFlow Lite с делегатом Edge TPU (для Google Coral (Coral AI, n.d.)). Все её основные блоки — depthwise и обычные свёртки, batch normalization, SiLU и сигмоидные активации, операции изменения размера и конкатенации — входят в перечни поддерживаемых операторов обеих сред исполнения. Это позволяет перенести модель на RK3588 и Edge TPU с минимальными архитектурными правками, избегая трудоёмкой реализации кастомных слоёв и сохраняя структурную целостность вычислительного графа. Более того, использование стандартного набора операций гарантирует эффективную полную целочисленную квантизацию (INT8) без необходимости в смешанной точности, что принципиально для обоих ускорителей. Таким образом, YOLO11n выступает в роли общей исходной точки для прямого сравнения двух платформ, обеспечивая честные условия замера точности (mAP) и скорости (FPS, латентность) на идентичном коде предобработки и постобработки.
Экспериментальная платформа Orange Pi 5: архитектура и инструментарий NPU
Измерения на стороне Rockchip производятся на одноплатном компьютере Orange Pi 5, представляющем собой законченную вычислительную систему с гетерогенной SoC RK3588S. В данном разделе описаны ключевые компоненты платформы и программные средства, использованные для конвертации и исполнения модели YOLO11n на встроенном нейропроцессоре.
Применение интегрированного NPU требует специализированного программного стека, центральным звеном которого выступает RKNN-Toolkit2 — среда для преобразования моделей из форматов PyTorch, ONNX (ONNX, n.d.) или TensorFlow в собственный формат RKNN, адаптированный под аппаратную архитектуру ускорителя. Процесс конвертации является критически важным этапом, поскольку перечень операций, эффективно отображаемых на NPU, ограничен. Архитектура YOLO11n была выбрана в том числе из-за использования стандартных свёрточных блоков, полностью входящих в белый список RKNN-Toolkit2, что позволило выполнить полную целочисленную квантизацию (INT8) (Yang et al., 2023) без внесения кастомных слоёв и с сохранением вычислительной точности.
В качестве аппаратной основы задействован одноплатный компьютер Orange Pi 5 с системой на кристалле Rockchip RK3588S, обеспечивающей оптимальный баланс между пиковой производительностью, энергоэффективностью и стоимостью для задач периферийного зрения. SoC построена по гетерогенному принципу: восемь ядер CPU разбиты на два кластера, что позволяет гибко распределять фоновые процессы и предобработку кадров, пока NPU выполняет инференс. Основные технические характеристики кристалла приведены в таблице 1.
Таблица 1/Table 1
Основные характеристики SoC Rockchip RK3588S
Main Features of the Rockchip RK3588S SoC
|
Компонент / Component |
Описание / Description |
|
Центральный процессор (CPU) / Central Processing Unit (CPU) |
8 ядер ARM / 8 ARM cores: • 4x Cortex-A76 @ до 2,4 ГГц / 4x Cortex-A76 @ up to 2.4 GHz • 4x Cortex-A55 @ до 1,8 ГГц / 4x Cortex-A55 @ up to 1.8 GHz |
|
Нейропроцессор (NPU) / Neuroprocessor (NPU) |
Производительность: до 6 TOPS (INT8) / Performance: up to 6 TOPS (INT8) Поддержка форматов: INT4/INT8/INT16 / Format support: INT4/INT8/INT16
|
|
Графический процессор (GPU) / Graphics Processing Unit (GPU) |
ARM Mali-G610 MP4 |
|
Процессор обработки видеосигнала (VPU) / Video Signal Processing Unit (VPU) |
Поддержка кодирования и декодирования 8K@60fps (H.265/HEVC, H.264/AVC) / Support for encoding and decoding 8K@60fps (H.265/HEVC, H.264/AVC) |
Плата Orange Pi 5 раскрывает возможности SoC, предоставляя необходимые периферийные интерфейсы и ресурсы памяти, критически важные при работе с полноразмерной моделью и видеопотоком. В таблице 2 перечислены характеристики конкретного экземпляра, использованного в эксперименте.
Таблица 2 / Table 2
Характеристики одноплатного компьютера Orange Pi 5
Characteristics of the Orange Pi 5 single-board computer
|
Параметр / Parameter |
Характеристика / Characteristic |
Описание / Description |
|
Оперативная память / Random access memory |
8 Гб LPDDR4 |
Достаточный объем высокоскоростной памяти для загрузки модели, буферизации видеокадров / Sufficient high‑speed memory capacity for loading the model and buffering video frames |
|
Память / Storage |
Слот M.2 для NVMe SSD, слот для micro-SD / M.2 slot for NVMe SSD, micro‑SD slot |
NVMe-накопитель позволяет быстро загружать большие модели и datasets, уменьшая время разработки и развертывания / An NVMe drive allows for fast loading of large models and datasets, reducing development and deployment time |
|
Интерфейсы камер / Camera interfaces |
2x порта MIPI-CSI / 2x MIPI‑CSI ports |
Позволяет подключать несколько камер, что расширяет область применения разрабатываемого решения / It allows you to connect multiple cameras, which expands the scope of application of the developed solution |
Методика конвертации модели
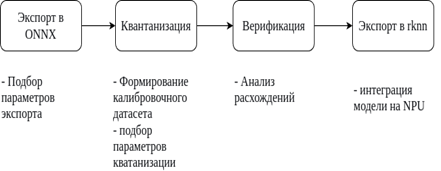
Конвертация YOLOv11 под NPU Rockchip — нетривиальный процесс, потребовавший выстраивания цепочки PyTorch-ONNX-RKNN. Исходная модель PyTorch сначала экспортировалась в ONNX(ONNX, n.d.) с фиксированным входным тензором (640×640, статический батч) — это необходимо для последующей статической оптимизации графа NPU. Все операторы, отсутствующие в белом списке RKNN-Toolkit2, заменялись эквивалентными стандартными слоями непосредственно на этапе экспорта.
Полученный ONNX-файл загружался в RKNN-Toolkit2 для трансформации в собственный формат NPU. Главный этап — посттренировочная статическая квантизация в INT8 (Rokh et al., 2023), обеспечивающая основной прирост быстродействия. Калибровка выполнялась на 100–200 изображениях из валидационной выборки COCO (COCO Dataset, n.d.). Инструментарий накапливал статистику активаций и автоматически вычислял масштаб и нуль-точку для каждого слоя. После квантизации проводилась верификация: сравнивались выходные тензоры FP32- и INT8-моделей на идентичных входах с использованием косинусной близости — это гарантирует, что семантика детекций не искажена преобразованиями.
Завершающим шагом стала компиляция в низкоуровневые инструкции NPU и экспорт бинарного файла .rknn, готового к исполнению на Orange Pi 5. Общий конвейер экспорта приведён на рисунке 1. По описанной методике были получены оптимизированные версии моделей YOLOv11n, YOLOv11s и YOLOv11m для дальнейших экспериментов.

Результаты работы на Orange Pi
Проведенные эксперименты позволили всесторонне оценить показатели точности и скорости работы модели YOLO11n на платформе Orange Pi 5. Важно отметить, что особенности данной платформы позволяют запускать инференс модели параллельно на разных рабочих процессах, эксплуатируя многозадачность гетерогенной архитектуры RK3588S. В таблице 3 представлены сводные результаты тестирования производительности при различном числе параллельных процессов инференса (от 2 до 6). Все замеры выполнены при фиксированном входном разрешении 640×640 с полной целочисленной квантизацией INT8, обеспечившей сохранение точности mAP@0,5 на уровне 55,5% — значение оставалось неизменным для всех конфигураций, поскольку модель, веса и способ квантизации идентичны (Seshadri et al., 2022).
Таблица 3 / Table 3
Сводные результаты тестирования производительности различных конфигураций
Summary results of performance testing of various configurations
|
Модель / Model |
mAP@0,5 |
Кол-во Процессов / Number of processes |
Загрузка NPU 1 средняя / Loading NPU 1 average |
Загрузка NPU 2 средняя / Loading NPU 2 medium |
Загрузка NPU 3 средняя / Loading NPU 3 medium |
Пик Температуры / Peak temperature |
FPS |
|
n |
55,5 |
2 |
44% |
5% |
0% |
54 C |
43 |
|
n |
55,5 |
3 |
52% |
18% |
2% |
63 C |
52 |
|
n |
55,5 |
4 |
54% |
20% |
3% |
67 C |
54 |
|
n |
55,5 |
5 |
60% |
24% |
8% |
69 C |
54 |
|
n |
55,5 |
6 |
60% |
24% |
18% |
71 C |
53 |
Таким образом, оптимальным компромиссом между производительностью, тепловыделением и резервом для сопутствующих задач является использование 3–4 параллельных процессов, обеспечивающих 52–54FPS при загрузке Core0 52–54% и температуре 63–67 °C. Достигнутые значения с большим запасом перекрывают требования большинства сценариев реального времени (видеоаналитика, роботизированные комплексы, промышленная автоматизация), а оставшиеся свободными ресурсы NPU могут быть задействованы для параллельного выполнения второй модели или аппаратной постобработки
Экспериментальная платформа Raspberry Pi 4 с Google Coral: архитектура и инструментарий Edge TPU
Вторая конфигурация для экспериментов построена на сочетании одноплатного компьютера Raspberry Pi 4 Model B и внешнего USB-ускорителя Google Coral (Coral AI, n.d.) с сопроцессором Edge TPU. В отличие от гетерогенной SoC RK3588S (Lee et al., 2026), где NPU интегрирован на кристалл и взаимодействует с CPU через внутри кристальные шины, здесь нейросетевой сопроцессор подключается по протоколу USB 3.0. Это накладывает дополнительный оверхед на передачу входных тензоров и загрузку результатов, что делает анализ сквозной задержки особенно показательным.
Основой платформы служит Raspberry Pi 4 Model B с 8 ГБ оперативной памяти LPDDR4-3200 — конфигурация, исключающая дефицит ОЗУ даже при работе с большими калибровочными наборами и промежуточными буферами предобработки. Центральный процессор (Broadcom BCM2711, 4×Cortex-A72 @ 1,5 ГГц) выполняет захват кадров, предварительную обработку и постобработку результатов инференса, оставляя матричные вычисления специализированному ускорителю.
В роли ускорителя задействован Coral USB Accelerator — компактный модуль на базе Google Edge TPU, ориентированный на вывод 8-битных целочисленных сетей. Его ключевые параметры приведены в таблице 4.
Таблица 4/ Table 4
Характеристики edge tpu
Edge tpu Specifications
|
Процессор / Processor |
Google Edge TPU coprocessor: 4 TOPS (int8); 2 TOPS per watt |
|
Интерфейс / Interface |
USB 3.0 Type-C* (data/power) |
|
Размер / Size |
65 mm x 30 mm |
Программное окружение платформы базируется на Debian GNU/Linux 12 (Bookworm), оптимизированном для ARM-архитектуры и обеспечивающем стабильную работу runtime-компонентов TensorFlow Lite. Инференс выполняется в среде Python 3.10 с библиотеками TensorFlow Lite Runtime 2.14 (сборка с поддержкой делегата Edge TPU) и PyCoral. Предобработка кадров реализована средствами OpenCV и NumPy.
Методика портирования
Перенос модели на сопроцессор Edge TPU требует полного цикла трансформации из формата PyTorch в специализированный исполняемый файл, совместимый с runtime-библиотекой TensorFlow Lite и делегатом ускорителя. Общая схема конвертации приведена на рисунке 2 и включает следующие этапы:
-
Экспорт из PyTorch в ONNX (ONNX, n.d.). Обученная модель YOLO11n сохраняется в формат .onnx с фиксацией входного размера 640×640 и статического батча. На этом шаге проводится первичный аудит операторов: все слои, заведомо отсутствующие в белом списке Edge TPU (например, некоторые экзотические активации), заменяются эквивалентными стандартными блоками, представленными в ONNX-спецификации.
-
Конвертация ONNX-TensorFlow-TensorFlow Lite.
Полученный ONNX-граф транслируется в формат TensorFlow SavedModel с помощью конвертера onnx-tf, после чего модель преобразуется в TensorFlow Lite FlatBuffer вызовом TFLiteConverter. Для соблюдения требований Edge TPU применяется полная целочисленная квантизация : веса и активации приводятся к 8-битному представлению, а калибровка выполняется на репрезентативном подмножестве из 200 изображений COCO (COCO Dataset, n.d.). Эта операция приводит к незначительной потере точности, но принципиально необходима — Edge TPU исполняет только 8-битные операции. -
Компиляция под Edge TPU. TFLite-файл пропускается через фирменный компилятор edgetpu_compiler. На выходе формируется модель, разбитая на два вычислительных подграфа: операции, успешно отраженные на аппаратуру Edge TPU, и операции, выполняемые на центральном процессоре. Итоговое распределение для YOLO11n отражено в таблице 5.

Рис. 2. Методика конвертации модели
Fig. 2. The method of model conversion
Таблица 5 / Table 5
Распределение операций модели YOLO11n после компиляции для Edge TPU
Distribution of YOLO11n model operations after compilation for Edge TPU
|
Модель / Model |
Количество операций на CPU / Number of operations per CPU |
Количество операций на TPU / Number of operations on the TPU |
|
yolov11 |
222 |
275 |
Значительная доля CPU-операций (45%) обусловлено архитектурными особенностями YOLO11: модель содержит множественные подграфы и нетривиальные комбинации слоёв, не поддерживаемые текущей версией Edge TPU-делегата (Небаба & Марков, 2024). В первую очередь это касается некоторых ветвей постобработки и нестандартных активаций, которые не удалось полностью исключить на этапе аудита без риска нарушения структурной целостности детектора и падения точности.
Несмотря на это, скомпилированная модель остаётся функциональной: в реальном времени интерпретатор TensorFlow Lite автоматически исполняет проблемные операции на четырех ядрах Cortex-A72 Raspberry Pi, а все поддерживаемые тензорные вычисления выносятся на Edge TPU. В экспериментах фиксировались как чистое время инференса на ускорителе, так и сквозная задержка, учитывающая затраты CPU и передачу данных по USB.
Результаты работы на Raspberry Pi 4B
В результате проведенных экспериментов получены объективные показатели точности и скорости работы модели YOLO11n на платформе Raspberry Pi 4B с ускорителем Google Coral Edge TPU (Coral AI, n.d.)). В отличие от Orange Pi 5, где весь инференс исполняется непосредственно на встроенном NPU, здесь модель после компиляции разбивается на два вычислительных подграфа — операции, отраженные на Edge TPU, и операции, оставленные на центральном процессоре. Итоговые метрики, зафиксированные при разрешении 448×448, сведены в таблице 6.
Таблица 6 / Table 6
Результаты тестирования моделей на edge TPU
Results of testing models on edge TPU
|
Модель / |
Размер (пикселей) / Size (pixels) |
mAP(50-96) |
Скорость(мс) |
Операции на TPU / TPU Operations |
|
YOLOv11n |
448 |
45,1 |
121,51 |
55,4% |
Скоростные показатели — 121,51 мс на кадр (около 8,2FPS) — демонстрируют более чем шестикратное отставание от Orange Pi. Ключевой фактор — распределение операций: лишь 55,4% тензорных вычислений делегированы ускорителю, а оставшиеся 44,6% исполняются на четырёх ядрах Cortex-A72 Raspberry Pi. Поскольку значительная часть арифметики, особенно в бэкбоне и пирамиде признаков, остаётся на центральном процессоре, общая пропускная способность упирается в его относительно низкую производительность на матричных операциях INT8. Дополнительный вклад в задержку вносит передача промежуточных тензоров между CPU и Edge TPU (Hosseininoorbin et al., 2023) по шине USB 3.0 — при каждом переключении контекста между подграфами возникают транзакционные накладные расходы. Попытка увеличить разрешение до 640×640, помимо выхода за пределы гарантированной совместимости с Edge TPU, привела бы к экспоненциальному росту объёма пересылаемых данных и ещё большей доле CPU-операций, что окончательно исключает такую конфигурацию из сценариев реального времени.
Таким образом, экспериментальные данные подтверждают, что Raspberry Pi 4B с Google Coral Edge TPU способен выполнять детекцию YOLO11n с приемлемой точностью для задач, не критичных к частоте кадров (например, периодический анализ фотографий или срабатывания по таймеру). Однако для непрерывного видеопотока и требовательных приложений реального времени платформа существенно уступает Orange Pi 5 как по скорости, так и по эффективности использования аппаратного ускорителя.
Результаты
Проведенные эксперименты позволяют выполнить прямое сопоставление двух аппаратных конфигураций — Orange Pi 5 (Rockchip RK3588S со встроенным NPU) и Raspberry Pi 4B с внешним ускорителем Google Coral Edge TPU (Coral AI, n.d.) — при исполнении модели YOLO11n. В качестве ключевых критериев сравнения выступают пропускная способность (FPS), сквозная задержка, достигнутая точность детекции, эффективность использования вычислительных ресурсов, тепловой режим и удобство интеграции в конечное решение.
Производительность и задержка. На платформе Orange Pi 5 модель YOLO11n, сконвертированная в формат RKNN с полной целочисленной квантизацией INT8 и входным разрешением 640×640 пикселей, продемонстрировала устойчивую частоту кадров в диапазоне от 43 до 54FPS в зависимости от уровня параллелизма. Максимальное значение 54FPS достигается уже при трех–четырех процессах инференса и сохраняется при дальнейшем наращивании числа потоков, что указывает на эффективное насыщение пропускной способности NPU без значительных накладных расходов на синхронизацию (Girshick, 2015). При этом сквозная задержка (от захвата кадра до получения координат) не превышает 19–23 мс, что более чем достаточно для подавляющего большинства задач реального времени, включая навигацию роботов, видеонаблюдение и взаимодействие с оператором.
Связка Raspberry Pi 4B + Google Coral USB Accelerator показала принципиально иные результаты. Модель, скомпилированная для Edge TPU с входным разрешением 448×448, достигает задержки 121,5 мс, что соответствует частоте около 8,2 кадров в секунду. Увеличение разрешения до 640×640, использованного на Orange Pi, привело бы к дополнительному падению FPS из-за роста объема передаваемых по USB данных и увеличения вычислительной нагрузки на неподдерживаемые Edge TPU (Boroumand et al., 2021) операции, выполняемые центральным процессором. Таким образом, по критерию пропускной способности Orange Pi 5 превосходит конкурента более чем в 6 раз, а с учётом полного разрешения — разрыв становится еще более значительным.
Эффективность использования аппаратуры. Архитектурное преимущество RK3588S проявляется в степени утилизации ускорителя. Средняя загрузка первого ядра NPU в оптимальных конфигурациях составляет 54–60%, пиковая загрузка второго ядра — до 24%, третье остаётся практически незагруженным. Это свидетельствует о значительном запасе вычислительной мощности для параллельного выполнения других моделей или дополнительных операций, таких как пред- и постобработка, прямо на NPU. На Raspberry Pi 4B картина диаметрально иная: скомпилированная модель оставляет 45% операций на четырех ядрах Cortex-A72, что не только снижает общую частоту кадров, но и загружает центральный процессор, ограничивая его доступность для сопутствующих задач. Внешнее подключение ускорителя по USB 3.0 добавляет транзакционные задержки и является дополнительной точкой отказа, а также требует осторожного обращения с кабельным соединением в вибронагруженных или мобильных установках.
При максимальной нагрузке температура NPU в составе Orange Pi 5 не превысила 71 °C при пассивном охлаждении, что является безопасным значением и не требует активного обдува в большинстве корпусов. Raspberry Pi 4B с Edge TPU также не демонстрирует критического нагрева, однако суммарное энергопотребление двух устройств (плата + USB-акселератор) выше, а КПД использования каждого ватта ощутимо ниже: 4 TOPS Edge TPU (20) против 6 TOPS NPU RK3588 при сравнимой стоимости решения с учётом покупки ускорителя.
Orange Pi 5 предлагает единообразный программный стек RKNN, позволяющий выполнить конвертацию, квантизацию и деплой в несколько команд с предсказуемым результатом. Интегрированный NPU не требует настройки внешних устройств, драйверов USB и опасности потери производительности из-за качества кабеля или помех. Разработчик получает готовый одноплатный модуль, способный работать с двумя MIPI-камерами напрямую, без посредников, что уменьшает габариты конечного изделия и повышает надежность.
По совокупности измеренных показателей — частоте кадров, задержке, эффективности использования ускорителя, удобству интеграции и запасу по вычислительной мощности — платформа Orange Pi 5 на базе Rockchip RK3588S (Geng et al., 2024) существенно превосходит конфигурацию Raspberry Pi 4B с Google Coral Edge TPU в задаче исполнения модели YOLO11n. Разрыв в скорости, достигающий 6–7 крат при более высоком разрешении, делает Orange Pi 5 предпочтительным выбором для любых сценариев, где требуется детекция объектов в реальном времени: от автономных камер и роботизированных платформ до систем промышленной автоматизации. Встроенный NPU демонстрирует не только высокую пиковую производительность, но и рациональное использование ресурсов, оставляя пространство для масштабирования. На основании полученных данных Orange Pi 5 может быть рекомендован как оптимальная аппаратная база для построения производительных и энергоэффективных edge-решений компьютерного зрения.