Введение
Применение этих технологий не только обеспечивает эффективное взаимодействие и координацию внутри предприятий и консорциумов, между различными подразделениями компаний, расположенными в разных регионах и государствах, но и способствует формированию индустриальных экосистем (Pauli et al., 2021). Такие экосистемы представляют собой взаимосвязанные сети, в которых участники, включая поставщиков, клиентов и контрагентов, могут взаимодействовать друг с другом, обмениваться данными и ресурсами, совместно разрабатывать новые продукты и услуги.
Таким образом, киберфизические системы и цифровые платформы становятся основными строительными блоками, на которых базируются инновационные бизнес-модели, способствующие устойчивому развитию и конкурентоспособности географически распределённых предприятий в условиях быстро меняющегося рынка.
Индустриальная цифровая платформа — это цифровая экосистема, в которой производители оборудования, разработчики, поставщики услуг и клиенты совместно создают и используют ценность на основе общих стандартов и данных (Müller, 2019). Цифровая экосистема для индустриальных цифровых платформ — это совокупность независимых акторов (производителей оборудования, разработчиков программного обеспечения, поставщиков услуг, интеграторов и промышленных потребителей), которые используют общую платформу для совместной разработки и использования решений на основе промышленных данных (Pauli et al., 2021).
Для разработки цифровых платформ, обеспечивающих оптимизацию производственной деятельности и формирование экосистем взаимодействия, ведущие технологические компании (Cisco, General Electric, IBM, Google, Яндекс) объединяют усилия в рамках специализированных консорциумов.
На самом высоком этапе развития платформы начинают формировать межотраслевые экосистемы, известные как «экострии» или «эгополии» (рис. 1).
Развить экосистему до экострии или эгополии можно, применяя технологии промышленного интернета вещей (IIoT), при условии, что участники цифровых платформ действуют в рамках эталонной стандартизированной распределённой бизнес-модели.
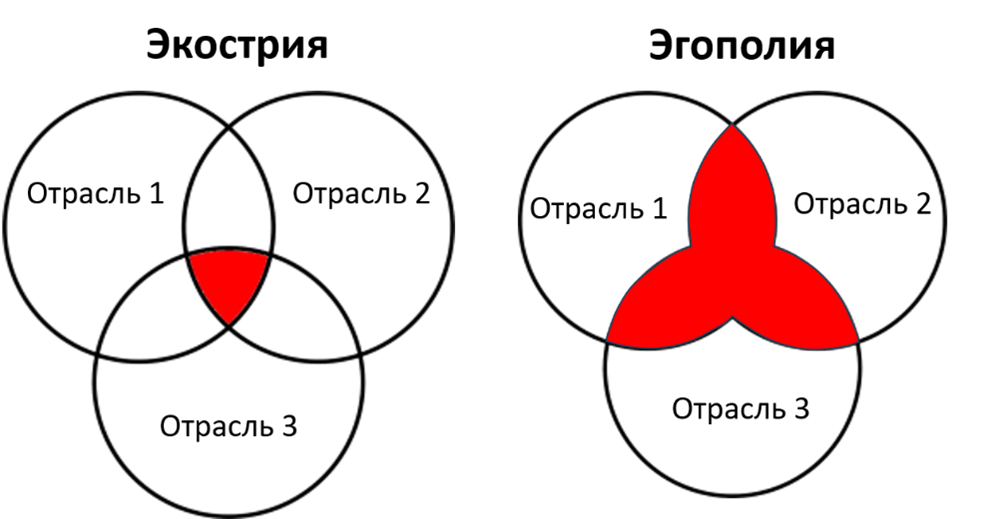

Эталонная (референтная) стандартизированная распределённая бизнес-модель — это обобщённая, типовая модель, описывающая роли участников индустриальной цифровой экосистемы при создании совместного продукта, а также принципы управления и монетизации, используемая как методологический ориентир при проектировании и производстве сложных технических систем. В контексте применения цифровых платформ и экосистем такая бизнес-модель является универсальной, абстрактной схемой, описывающей типовые роли участников, их ценностные предложения, способы создания и распределения ценности (Каленов, 2022). Такого рода экосистемно-ориентированные бизнес-модели строятся вокруг логики совместного создания и распространения ценности между участниками (Rong et al., 2023).
На текущем этапе развития технологий интеллектуального производства существует несколько ведущих стандартизированных референтных моделей, ориентированных на распределённые бизнес-модели с применением технологий IIoT и «Индустрию 4.0». Эти модели используются различными высокотехнологичными консорциумами. Как показано в работе (Фомин, 2025), наиболее востребованной, структурно проработанной и подходящей для реализации в России является концепция референтной модели Representation of Reference Architecture Industry 4.0 (RAMI 4.0).
RAMI описывает производственные активы через три ключевых аспекта, образующих так называемый многомерный RAMI-куб: измерения, определяющие уровни (слои), производственных активов, оборудования, систем и бизнес-процессов (Hierarchy Levels); измерения, определяющие отношение актива к организационной структуре предприятий, находящихся в общей экосистеме (Integration Layers); измерения, определяющие жизненный цикл, продукции и элементов систем (Life Cycle).
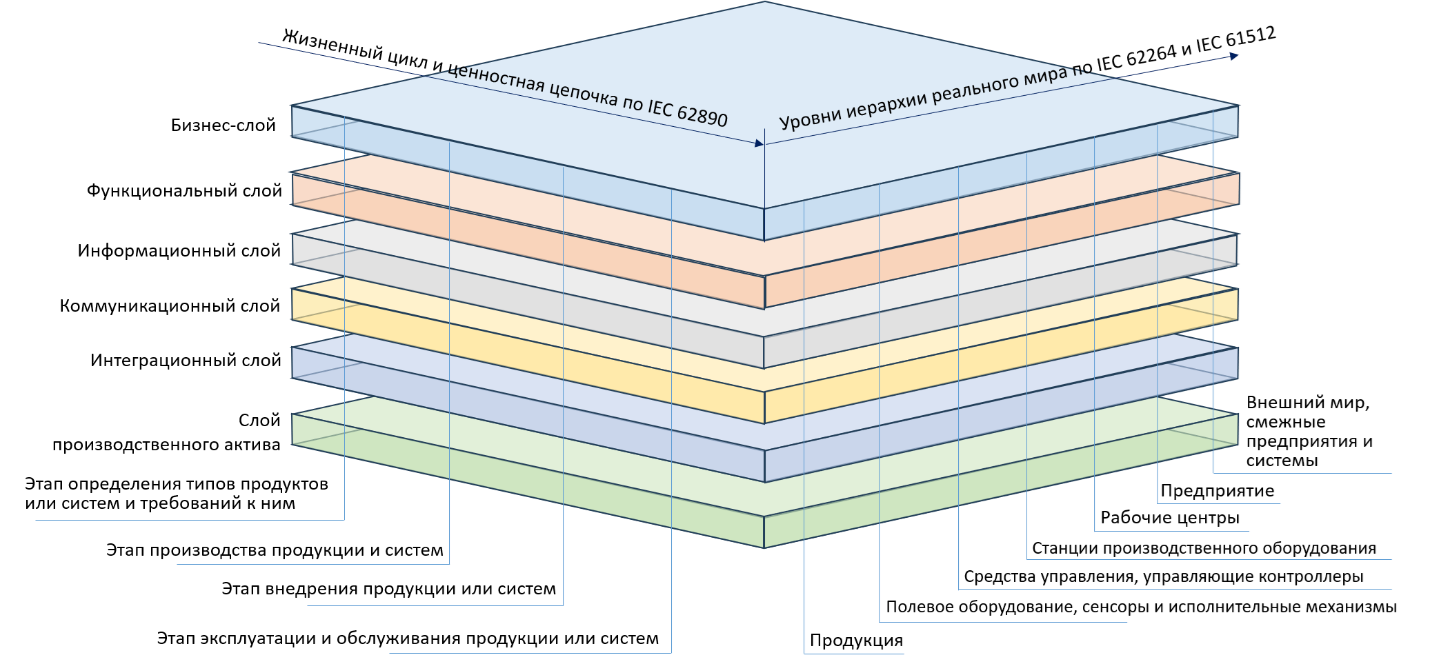
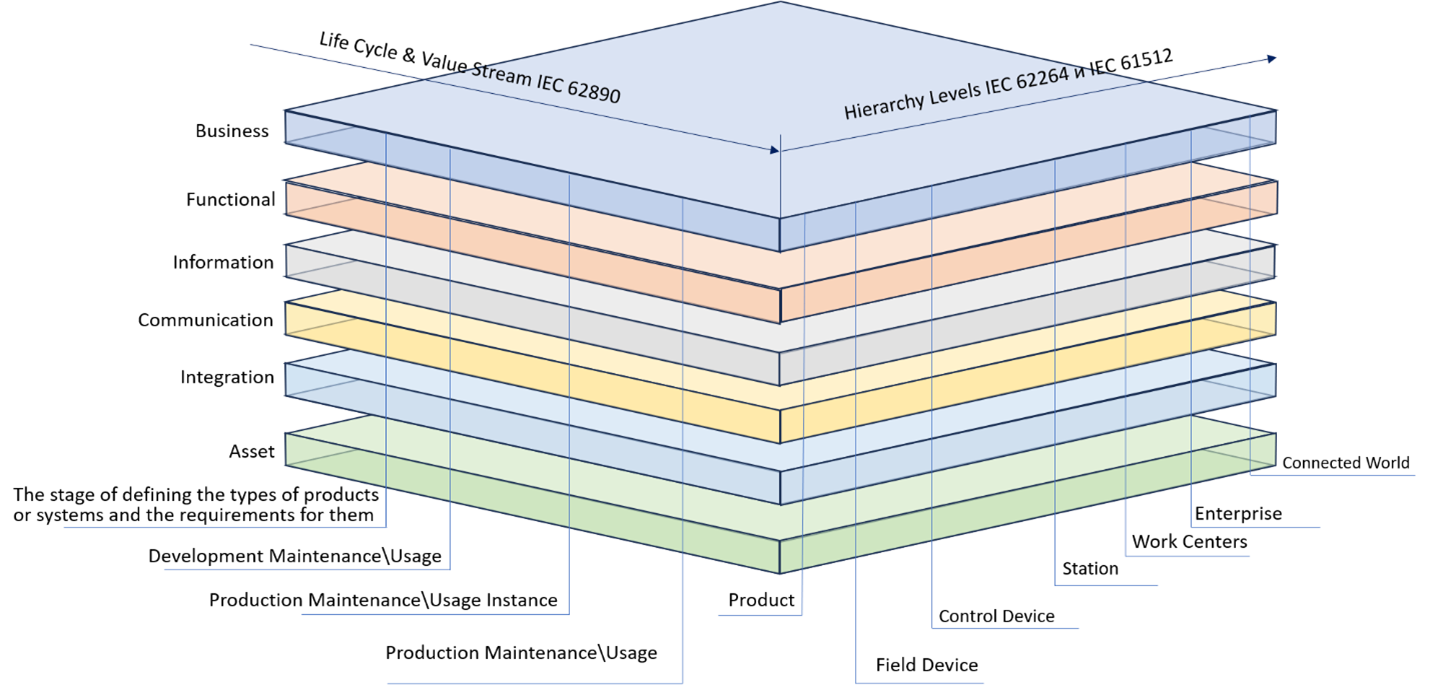
Такой подход позволяет интегрировать любой актив или технический компонент с другими смежными активами и математически описать координаты любого элемента в RAMI-кубе (рис. 2). Определить эти координаты для сотен тысяч элементов производственных активов — очень сложная задача. Она требует формальную классификацию элементов, определение координат в многомерной модели, валидацию на соответствия стандартам и техническим требованиям. Ранее эти функции успешно автоматизировались применением методов анализа данных для формирования онтологии предметной области (Антонов, Воронов, 2011). На современном этапе всё чаще подобные функции возлагаются на интеллектуального ассистента (ИИ-ассистента), который может автоматически описывать элементы активов и технических систем, расписывая их по измерениям RAMI-куба.
В отличие от предыдущих исследований, фокусирующихся на теоретических аспектах RAMI (Megow, 2020), настоящая работа предлагает практическую реализацию ИИ-ассистента для автоматизации процессов. Главная гипотеза: автоматизация на основе онтологических моделей повысит эффективность. Цели: формализовать функции ИИ-ассистента, разработать модель данных и прототип.
Функции ИИ-ассистента для ввода данных в референтную модель RAMI 4.0
AI-ассистент – это программное обеспечение, которое самостоятельно выполняет набор различных функций посредством управления различными специализированными программами или контроллерами индустриальных цифровых платформ, обладающее возможностью обучаться на накопленных данных или, используя предобученные модели, принимать решения по своим действиям на основе собранной информации и управлять бизнес-процессами. AI- или ИИ-ассистентов уже начали применять в логистике, бухгалтерском учёте, в энергосберегающем инжиниринге, в управлении качеством. ИИ-ассистент может автоматически находить объекты, неотражённые в референтной модели цифровой платформы, и вносить их в соответствующие базы данных, наполняя базу знаний о том или ином объекте. Для исследовательских задач такого рода ассистента можно реализовать на общедоступной платформе Google Colab.
ИИ-ассистент, предназначенный для актуализации баз знаний, используя базы знаний, основанные на онтологических моделях, должен выполнять следующие ключевые функции:
- Настройка ИТ-среды и загрузка сведений о модели RAMI: инициализирует программную среду, устанавливает необходимые фреймворки и библиотеки, формирует прикладную модель RAMI 4.0.
- Предобработка текстовых описаний и интерпретация нечётких требований: выполняет предварительную обработку текстового описания нового элемента (например, «интеллектуальный переключатель») и описаний категорий многомерной модели RAMI (например, «эксплуатация, использование, работа»).
- Классификация элемента: определяет тип элемента (например цифровой или физический актив предприятия).
- Определение координат в многомерной модели: устанавливает координаты элемента по трём измерениям, в соответствии с концепцией RAMI 4.0.
- Интеграция элемента в многомерную модель: добавляет новый элемент как экземпляр нового актива (например, «интеллектуальный переключатель» как экземпляр физических активов предприятия), определяет связи и предикаты новых элементов с другими элементами систем.
- Валидация соответствия стандартам: проверяет корректность интеграции элемента, сравнивая координаты и связи с требованиями стандартов (ГОСТ Р 59799, IEC 62890, IEC 62264, IEC 61512 и др.), и вносит корректировки при необходимости.
- Представление результатов пользователю в виде таблиц или дашбордов.
- Корректировка на основе обратной связи: принимает уточнённое описание элемента от пользователя (например, «интеллектуальный переключатель в разработке»), повторно выполняет классификацию и интеграцию, обновляя многомерную модель при необходимости.
Чтобы определиться с методами и инструментами разработки AI-ассистента с такими функциями требуется выполнить формальную постановку задачи, в которой произвести отнесение вышеперечисленных функций AI-ассистента к его функциональным блокам и к массивам данных, которые они должны обрабатывать.
Для формализации технической задачи разработки AI-ассистента определим массивы данных, которые должны храниться и обрабатываться AI-ассистентом для выполнения своих функций. Для этого определим необходимые данные для каждой функции AI-ассистента.
Для настройки программной среды ИИ-ассистента потребуются набор данных о производственных активов, которые описаны референтной моделью, её концептов, в соответствии с требованиями стандартов. Это массив данных D1. Главной функцией AI-ассистента является наполнение или обновление сформированной модели в массиве D2 и формирование набора связей, которые могут быть описаны на естественном языке, в виде тезауруса D3. Эти связи и отношения должны формировать векторные представления терминов из тезауруса в виде массива данных об их векторных представлениях D3.1.
Пользователь должен вводить текстовое описание активов (элементов и объектов систем), формируя массив данных D4, приводя его к тезаурусу D3, а AI-ассистент должен формализовать исходные описания категорий, в соответствии с установками, заданными в массиве D1, формируя массив данных D5 с исходным описанием различных параметров, включая тип, класс и категорию элементов, которые вошли в D1. Обработка данных D3, D4, D5 и формирует массив векторных представлений D3.1.
На основании определённых координат и связей элементов, их стадий жизненного цикла Life Cycle, уровня иерархии Hierarchy Levels и слоёв архитектуры Integration Layers, должен формироваться общий массив данных, в который входят классы, связи элементов и их координаты по осям RAMI-куба. Именно эта информация должна визуализироваться для пользователя, валидироваться, корректироваться и обновлять онтологию D2.
Для решения этой задачи применяются современные модели эмбеддингов, которые способны учитывать семантическую близость терминов и контекст употребления слов. Это позволяет повысить качество поиска и классификации элементов по сравнению с традиционными статистическими методами. Для этого применяют модели Sentence-BERT (Reimers, Gurevych, 2019), E5 9. (Wang, Yang, 2022) и BGE (Xiao, Liu, 2024), которые демонстрируют высокую эффективность в задачах семантического поиска, информационного извлечения и сопоставления текстовых описаний объектов. Применение классических операций обработки текстов с созданием TF-IDF-векторов для создания прототипов ИИ-ассистентов тоже вполне оправдано (Поляков, 2025).
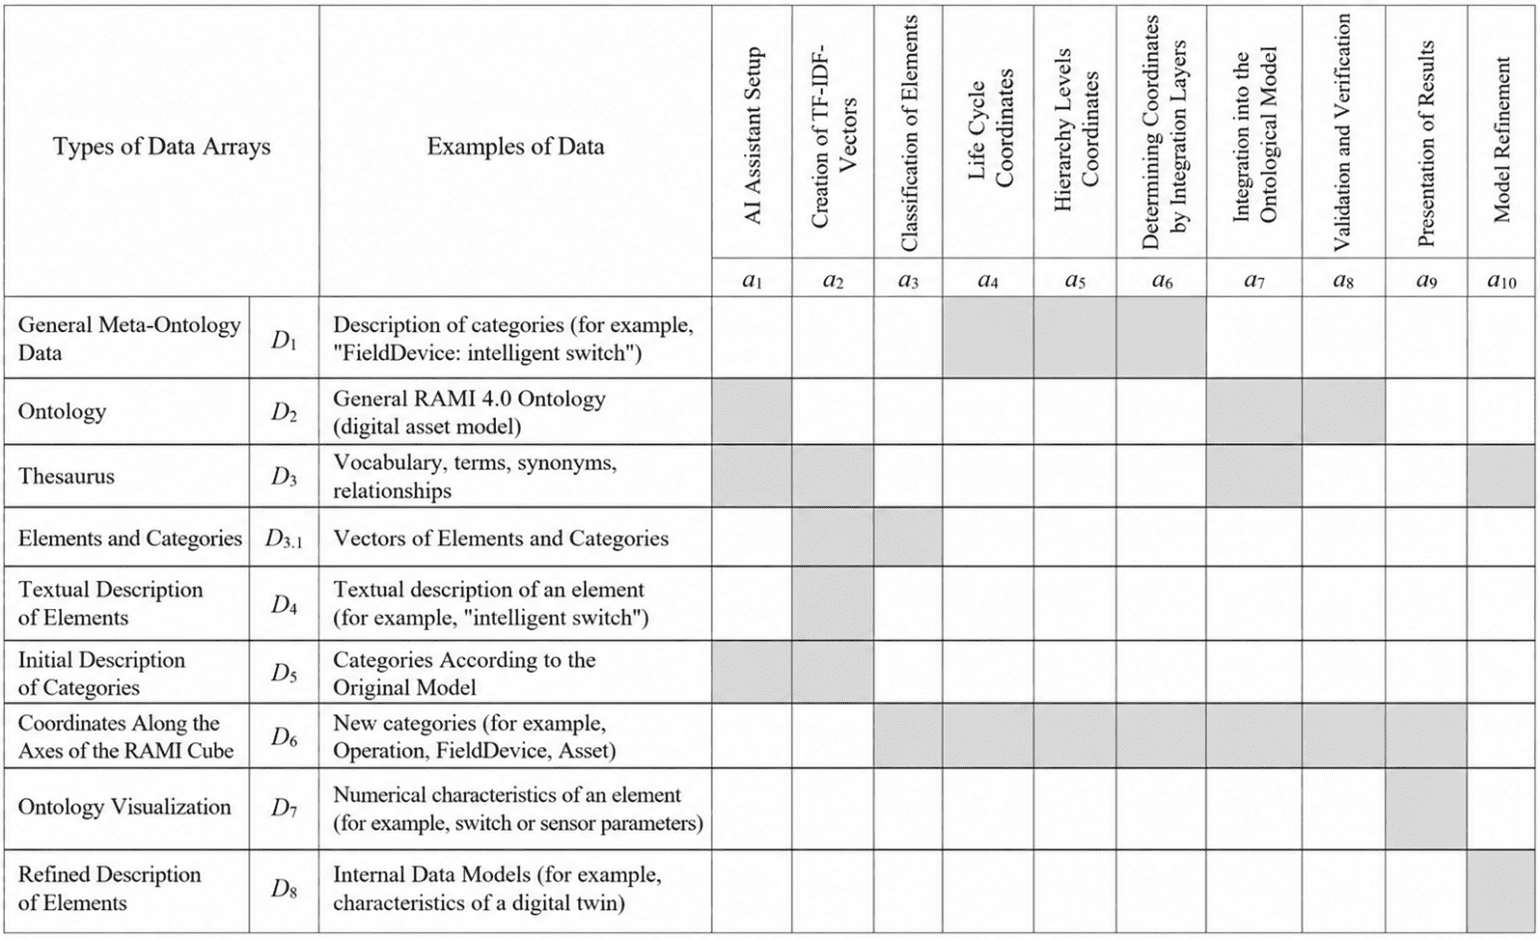
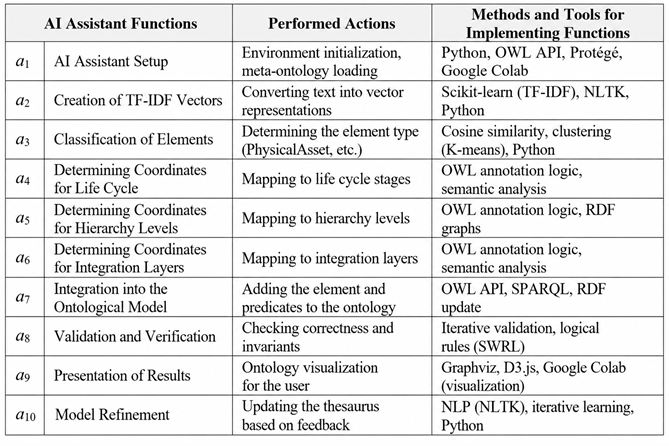
Проведя теоретико-информационный анализ референтной модели, связывающей элементы систем в терминах многомерной RAMI-модели на первом этапе исследований были формализованы функции и связанные с ними массивы данных ИИ-ассистента (таб. 1). Таблица показывает идентифицированные виды данных, которые формируются и обрабатываются на разных этапах функционирования интеллектуального ассистента.
Такое представление данных дало возможность операцию первичной настройки ИИ-ассистента для формирования массивов D3, D4, D5 обозначить через a1, а операцию обработки текстов с созданием TF-IDF-векторов - через a2. При этом разрабатываемой информационной системе потребуется использование операции объединения a7 для добавления элементов в онтологию, операции проекции a3 – a6 для извлечения координат, операций фильтрации a8 для проверки, коррекции и преобразования информации, а также операций a9, которая преобразует данные в визуализированную форму для представления пользователям. В случае, если пользователь будет производить уточнённое описание элементов a9, то потребуется использование массива данных с уточнённым описанием D8, которые обновляют ранее созданный тезаурус D3. Результаты проведённого теоретико-информационного анализа процессов и функций ИИ-ассистента представлены в таб. 1.
Для реализации интеллектуального ассистента в виде информационной системы формализуем вышеописанные процессы обработки данных.
Для реализации гибкой многомерной RAMI-модели для изменяющихся и управляемых элементов систем определим совокупность взаимосвязанных областей знаний или семантических пространств, которые описывают различные аспекты производственных активов в рамках референтной архитектуры RAMI 4.0 в виде множества доменов, которые можно реализовать на платформе Google Colab.
- классы активов (например, физический или цифровой актив), уровни иерархии (уровень устройств, уровень оборудования или уровень предприятия);
- слои интеграции (это активы, или их процессы коммуникации, или бизнес-процессы предприятия и т.п.);
- этапы жизненного цикла (разработка, эксплуатация, техническое обслуживание и т.п.)3;
- динамические характеристики (например, изменяющиеся состояния надежности или производительности).
Применение этих сущностей в онтологической модели ИИ-ассистента позволит каждое множество доменов определить через базу знаний. В такой базе знаний домены могут быть связаны предикатами, включать разношкальные переменные (числовые и лингвистические) с функциями принадлежности для учета неопределенности параметров активов и связей (Дли М. И., 2023), а также применять так называемые эволюционные и квазигенетические алгоритмы, обеспечивающие генерацию последовательности запросов, организованных по специальной логической схеме, включающие, с последующим анализом подобранных ИИ-ассистентом данных методами многомерного статистического анализа (Куравский, Л.С. и др. 2025).
Таблица 1
Функции и связанные сними массивы данных AI-ассистента
|
Виды массивов данных |
Примеры данных |
Настройка AI-ассистента |
Создание TF-IDF- векторов |
Классификация элементов |
Координаты Life Cycle |
Координаты Hierarchy Levels |
Определение координат по Integration Layers |
Интеграция в онтологическую модель |
Валидация и проверка |
Представление результатов |
Уточнение модели |
|
|
a1 |
a2 |
a3 |
a4 |
a5 |
a6 |
a7 |
a8 |
a9 |
a10 |
|||
|
Данные общей мета-онтологии |
D1 |
Описание категорий (например, "FieldDevice: интеллектуальный переключатель) |
|
|
|
|
|
|
|
|
|
|
|
Онтология |
D2 |
Общая онтология RAMI 4.0 (цифровая модель актива) |
|
|
|
|
|
|
|
|
|
|
|
Тезаурус |
D3 |
Словарь, термины, синонимы, отношения |
|
|
|
|
|
|
|
|
|
|
|
Элементы и категории |
D3.1 |
Вектора элементов и категорий |
|
|
|
|
|
|
|
|
|
|
|
Текстовое описание элементов |
D4 |
Текстовое описание элемента (например, " интеллектуальный переключатель ") |
|
|
|
|
|
|
|
|
|
|
|
Исходное описание категорий |
D5 |
Категории по исходной модели |
|
|
|
|
|
|
|
|
|
|
|
Координаты по осям RAMI-куба |
D6 |
Новые категории (например, Operation, FieldDevice, Asset) |
|
|
|
|
|
|
|
|
|
|
|
Визуализация онтологии |
D7 |
Численные характеристики элемента (например, параметры переключателя или датчика) |
|
|
|
|
|
|
|
|
|
|
|
Уточнённое описание элементов |
D8 |
Внутренние модели данных (например, характеристики цифрового двойника) |
|
|
|
|
|
|
|
|
|
|
Table 1
Functions and associated data arrays of the AI assistant
Формальная постановка задачи ввода информации об элементах технических систем в структуру цифровых платформ
Пусть U — универсальное множество, содержащее все возможные данные, с которыми может работать система (тексты, онтологии, векторы, координаты и т.д.). Опираясь на функции AI-ассистента, концепты и предикаты онтологической модели RAMI, выделим подмножества в виде массивов данных для каждого хранилища и внешней сущности:
-
-D1 ⊆ U: - множество данных из «Общая мета-онтология, стандарты IEC 62890, IEC 62264, IEC 61512» (стандарты и концепты).
-
-D2 ⊆ U: - множество данных «Обновлённая онтология» (инстанции, классы, предикаты).
-
-D3⊆U: - множество данных «Тезаурус» (лингвистические связи, синонимы).
-
-D3.1 ⊆ U: - множество данных «TF-IDF-векторы элементов и категорий» (векторные представления)
-
-D4 ⊆ U: - множество данных «Текстовое описание элементов» (исходные тексты пользователей)
-
-D5 ⊆ U: - множество данных «Исходное описание категорий» (описания классов из стандартов).
-
-D6 ⊆ UD: - множество данных «Координаты и связи элементов по осям RAMI-куба» (классификации, координаты, связи).
-
-D7 ⊆ U: - множество данных «Визуализированная представленная онтология» (результаты визуализации).
-
-P ⊆ U: - множество данных от внешней сущности «Пользователь» (ввод текста и обратная связь).
-
-R ⊆ U: - множество данных для внешней сущности «Пользователь» (результаты или вывод визуализированной онтологии).
Каждый процесс информационной системы ai (i = 1…10) можно представить как отображение (функцию) между множествами: ai : Ai → Bi , где Ai — входные множества, Bi — выходные множества. Тогда общий процесс можно представить как композицию функций:
F = a10 ∘ a9 ∘ a8 ∘ a7 ∘ a6 ∘ a5 ∘ a4 ∘ a3 ∘ a2 ∘ a1,
где вход — P ∪ D1 ∪ D8, а выход — R ∪ D7. После представления результатов обработки данных предполагается возможность уточнения модели пользователем, т.е. предусмотрена итерация через a10 (таб. 4), которая добавляет обратную связь: a10 (P) → D3 → a2, образуя цикл.
Пусть S = D1 ∪ D2 ∪ D3.1 ∪ D3 ∪ D4 ∪ D5 ∪ D3.2 ∪ D6 ∪ D7 — множество состояний системы, состоящее из разных массивов данных, которые необходимо обрабатывать AI-ассистенту. Тогда изменение состояний на этапах функционирования системы можно представить как переход состояний: St+1 = Update(St, ai(Ai)), где ai — текущий процесс.
В таких обозначениях, формальной задачей становится разработать модель последовательности обработки информации AI-ассистентом, который осуществляет переходы состояний системы посредством осуществления операций над множествами (массивами данных), определёнными в таб. 1:
- объединение (используется в a7 для добавления элементов в онтологию);
- проекция (используется в функциях a3 – a6 для извлечения координат);
- фильтрация (используется в функции a8 для проверки и коррекции);
- преобразование (в функции a2 преобразует текст в векторы, а в функции a9 преобразует данные в визуализацию).
Структура онтологической модели цифровой платформы на основе референтной бизнес-модели
Как было сказано выше, индустриальные цифровые платформы функционируют на основе общих стандартов и данных. Общие данные служат основой формирования баз знаний о производственных активах, оборудовании, технических системах, элементов продукции. Управление базами знаний производится с применением онтологического подхода.
Онтологический подход подразумевает структурирование и организацию знаний в виде формальных моделей, которые описывают понятия и их взаимосвязи в определенной области. В контексте географически распределённых производственных предприятий, использующих концепцию «Индустрии 4.0», онтологический подход позволяет создать единую модель, которая будет объединять данные о различных аспектах производственных процессов, оборудовании и продуктах.
При проектировании структуры данных киберфизической системы промышленных предприятий, находящихся в одной экосистеме, с применением онтологического подхода, требуется:
- •определить концепты и понятия в терминологии RAMI4.0 (например, «машина», «процесс», «продукт») и их свойства, определить методы борьбы с неоднозначностью.
- •определить связи между понятиями, которые могут быть заданы текстом и лингвистически разными постановщиками задач, инженерами, на разных предприятиях (при этом один объект может быть «частью» другого, или «использоваться» для выполнения определённого процесса).
- •обеспечить унификацию и иерархичность различных сведений о реальных и абстрактных сущностях (активах), применяющихся в производственных процессах, являющихся элементами цифровых моделей предприятий, производственных процессов и производимых продуктов.
- •обеспечить возможность расширения онтологий новыми понятиями и отношениями, что позволяет адаптироваться к меняющимся требованиям и новым тенденциям в области управления знаниями.
В результате применения онтологического подхода в контексте «Индустрии 4.0» предприятия могут более эффективно хранить, обрабатывать и обмениваться данными, тем самым повышая уровень автоматизации, улучшая принятие решений на основе данных и оптимизируя производственные процессы.
Онтологическая модель индустриальной платформы должна состоять из мета-онтологии, которую организовывает администратор цифровой платформы и прикладных эталонных моделей, которые формируются производственными предприятиями, входящими в экосистему цифровой платформы.
Для разработки модели данных ИИ-ассистента потребовалось формализовать классифицированный список концептов онтологической модели цифровой платформы на основе стандартизированной бизнес-модели RAMI 4.0 (таб. 2).
Концепты онтологической модели RAMI 4.0
Concepts of the RAMI 4.0 ontological model
|
Концепт / The concept |
Комментарий / Comment |
|
Жизненный цикл и ценностная цепочка по IEC 62890 |
|
|
Типы /Type |
Описывает тип информации или данных, используемых в системе / Describes the type of information or data used in the system |
|
Примеры / Instance |
Конкретные реализации или экземпляры типов / Specific implementations or instances of types |
|
Иерархические уровни по IEC 62264 / Hierarchical levels according to IEC 62264 |
|
|
Продукция (Product) |
Описывает физические объекты, продукцию / Describes physical objects, products |
|
Полевое оборудование / Field Device |
Описывает элементы производственных линий, интеллектуальные переключатели и исполнительные механизмы / Describes the elements of production lines, intelligent switches, and actuators |
|
Средства управления / Control Device) |
Описывает управляющие контроллеры / Describes the control controllers |
|
Производственные станции / Station |
Описывает рабочие станции или станки или агрегаты / Describes workstations, machines, or units |
|
Производственные линии и рабочие центры / Work Centers |
|
|
Предприятие / Enterprise |
Описывает структуры и элементы, относящиеся к уровню управления предприятием / Describes the structures and elements related to the enterprise management level |
|
Внешний мир / Connected World |
Описывает сведения о смежных предприятиях и системах / Describes information about related enterprises and systems |
|
Архитектура по EC 61512 / Architecture according to EC 61512 |
|
|
Активы /Asset |
Физические, абстрактные и цифровые активы / Physical, abstract, and digital assets |
|
Продукт / Product |
Продукты и их компоненты / Products and their components |
|
Интеграция / Integration |
Интеграция данных и систем / Integration of data and systems |
|
Коммуникация / Communication |
Обмен данными и информацией / Data and information exchange |
|
Информация / Information |
Управление данными и информацией / Data and information management |
|
Функциональная безопасность / Functional Safety |
Обеспечение безопасности систем / Ensuring system security |
|
Бизнес / Business |
Управление бизнес-процессами / Business process management |
|
Уровни интеграции по IEC 62890 / Integration levels according to IEC 62890 |
|
|
Слой производственного актива / Digital Representation |
Описывает цифровые модели и двойники / Describes digital models and digital twins. |
|
Интеграционный слой / Integration |
Описывает элементы, обеспечивающие интеграцию разных систем и данных / Describes the elements that ensure the integration of different systems and data |
|
Коммуникационный слой / Communication |
Описывает физические и логические соединения / Describes physical and logical connections |
|
Информационный слой / Information |
Данные, информация, массивы данных / Data, information, arrays of data |
|
Функциональный слой / Functional |
Описывает функции и сервисы элементов систем / Describes the functions and services of system elements |
|
Бизнес-слой / Business |
Описывает бизнес-процессы и модели / Describes business processes and models |
Выявленные свойства позволили определить оптимальный набор предикатов, которые могут автоматически сформировать цифровую модель элемента производственной системы в виде онтологии. При разработке онтологической модели вышеопределённые концепты были связаны между собой в онтологическую модель через набор предикатов. При этом, каждому из предполагаемых предикатов определялся квантор существования и квантор общности, а затем предикаты были распределены по категориям. Это дало возможность не только упростить их использование, но и реализовать структуру данных в ERP-системе, в соответствии с разработанной системой предикатов.
Эксперименты с онтологическими моделями, построенными с помощью больших языковых моделей популярных нейросетей и редакторами онтологий позволили впервые сформировать структуру предикатов, которая, вместе с структурой классов полностью формирует онтологическую модель, на которой может быть построена структура знаний об элементах технических систем, объединённых в индустриальную цифровую платформу (таб. 3).
Таблица 3
Предикаты онтологической модели RAMI 4.0
|
Класс |
Подкласс |
Предикат |
|
Соответствует (correspondsTo) |
Соответствует этапам жизненного цикла (IEC 62890) |
Соотносит тип актива с этапом жизненного цикла (isTypeOf)
|
|
Определяет регламентирующий стандарт для этапа жизненного цикла элемента системы (conformsTo) |
||
|
Определяет этап жизненного цикла (hasLifeCycleStage)
|
||
|
Соответствует уровням иерархии (IEC 62264 и IEC 61512) |
Соотносит тип актива с уровнем иерархии (isTypeOf) |
|
|
Определяет уровень иерархии (belongsToLevel |
||
|
Взаимодействует (interactsWith) |
Взаимодействует на этапах жизненного цикла (IEC 62890) |
Определяет элементы, с которым взаимодействует актив на разных этапах ЖЦ (interactsWith) |
|
Определяет элементы, с которыми актив взаимодействует на физическом уровне (hasPhysicalConnection) |
||
|
Определяет элементы, с которыми актив взаимодействует на цифровом уровне (hasDigitalConnection) |
||
|
Определяет требования к синхронизации физического и цифрового актива (synchronizesWith) |
||
|
Взаимодействует с объектами (IEC 62264 и IEC 61512) |
Определяет компоненты или системы, которые выдают управляющие воздействия (controlledBy) |
|
|
Определяет компоненты или системы, которые собирают данные об исполнении функций (controls) |
||
|
Определяет этапы процесса, на которых происходит взаимодействие с активом (executesProcess) |
||
|
Управляет (controls) |
Управляет этапами жизненного цикла (IEC 62890) |
Определяет фазы жизненного цикла, на которых происходит управление активом (executesProcess) |
|
Определяет требования к управляющим воздействиям (controlledBy) |
||
|
Определяет требования к информации об исполнении функций (controls) |
||
|
Управляет объектами (IEC 62264 и IEC 61512) |
Определяет функции управления активом (executesProcess) |
|
|
Определяет управляющий элемент для актива (controlledBy) |
||
|
Определяет управляемый элемент для актива (controls) |
Table 3
Predicates of the RAMI 4.0 ontological model
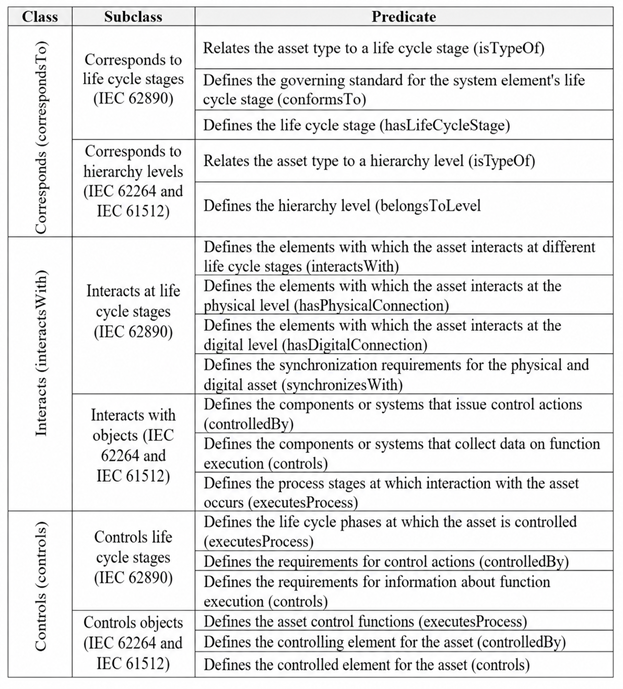
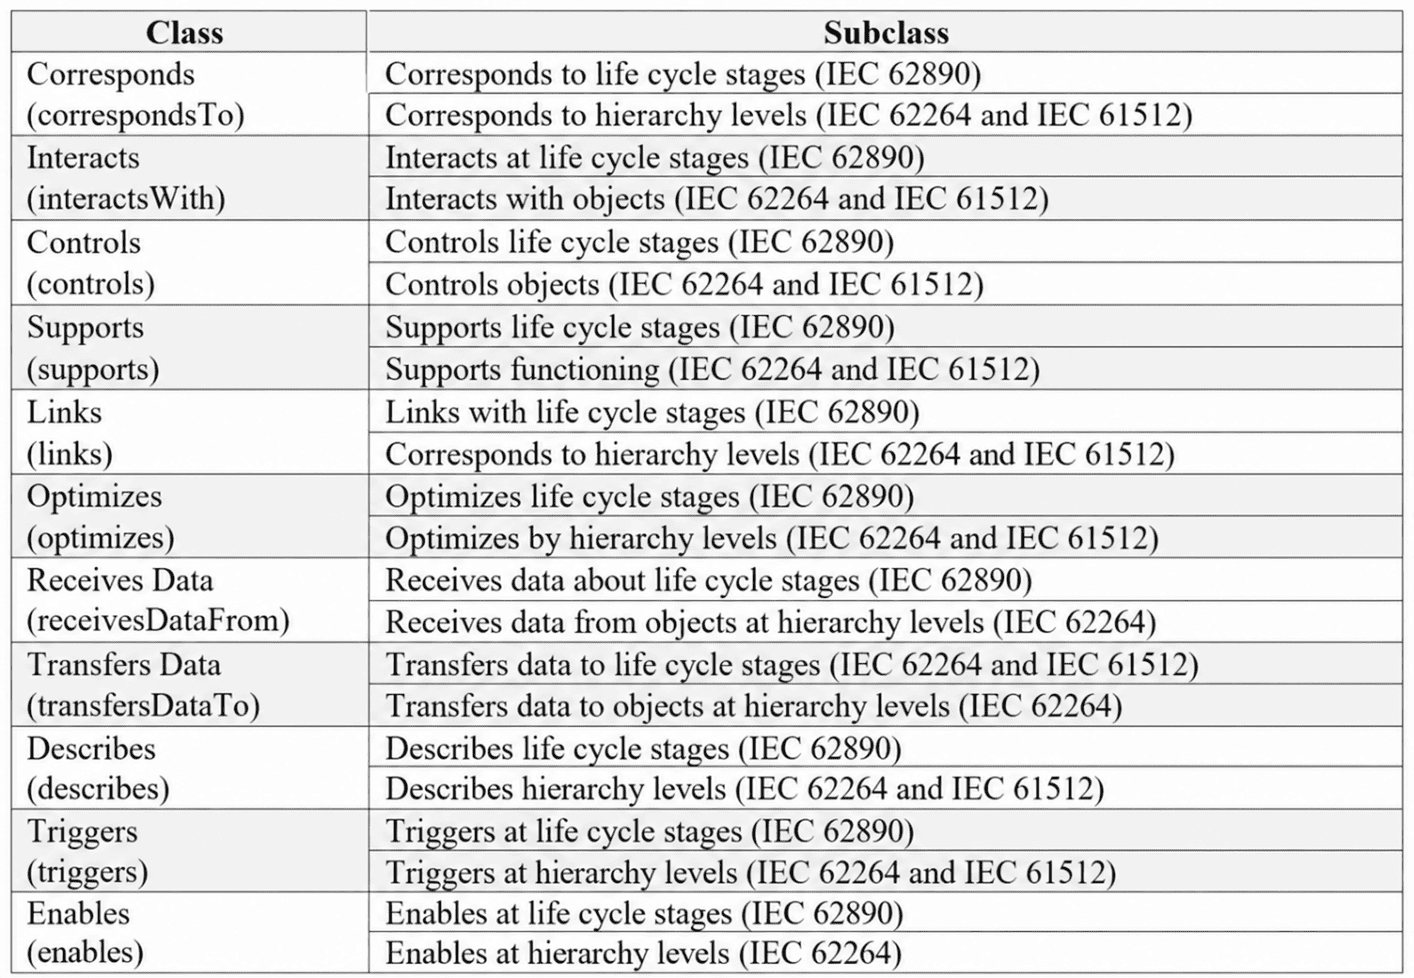
Несколько десятков предикатов невозможно отразить в рамках статьи, поэтому в таб. 4 приведён укрупнённый классификатор классов предикатов. Каждый подкласс предикатов в этой таблице может содержать от двух до пяти предикатов, которые с высокой точностью определяют координаты любого элемента технической системы в многомерном RAMI-кубе. Например, подкласс «Передаёт данные на этапы ЖЦ», в соответствии с ГОСТ Р 59799, IEC 62264 и IEC 61512, содержит набор предикатов «Определяет требования к указанию объектов и компонентов, в адрес которых актив передаёт информацию (sendsDataTo)», «Определяет требования актива передавать сведения в смежные системы и компоненты (transfersDataTo)», «Определяет требования к хранению данных на разных этапах жизненного цикла (storesDataIn)».
Подклассы предикатов онтологической модели RAMI 4.0
|
Класс |
Подкласс |
|
Соответствует (correspondsTo) |
Соответствует этапам жизненного цикла (IEC 62890) |
|
Соответствует уровням иерархии (IEC 62264 и IEC 61512) |
|
|
Взаимодействует (interactsWith) |
Взаимодействует на этапах жизненного цикла (IEC 62890) |
|
Взаимодействует с объектами (IEC 62264 и IEC 61512) |
|
|
Управляет (controls) |
Управляет этапами жизненного цикла (IEC 62890) |
|
Управляет объектами (IEC 62264 и IEC 61512) |
|
|
Поддерживает (supports) |
Поддерживает этапы жизненного цикла (IEC 62890) |
|
Поддерживает функционирование (IEC 62264 и IEC 61512) |
|
|
Связывает (links) |
Связывает с этапами жизненного цикла (IEC 62890) |
|
Соответствует с уровнями иерархии (IEC 62264 и IEC 61512) |
|
|
Оптимизирует (optimizes) |
Оптимизирует этапы жизненного цикла (IEC 62890) |
|
Оптимизирует по уровням иерархии (IEC 62264 и IEC 61512) |
|
|
Получает данные (receivesDataFrom) |
Получает данные об этапах ЖЦ (IEC 62890) |
|
Получает данные от объектов на уровнях иерархии (IEC 62264) |
|
|
Передаёт данные (transfersDataTo) |
Передаёт данные на этапы ЖЦ (IEC 62264 и IEC 61512) |
|
Передаёт данные в объекты на уровнях иерархии (IEC 62264) |
|
|
Описывает (describes) |
Описывает этапы жизненного цикла (IEC 62890) |
|
Описывает уровни иерархии (IEC 62264 и IEC 61512) |
|
|
Запускает (triggers) |
Запускает на этапах жизненного цикла (IEC 62890) |
|
Запускает на уровнях иерархии (IEC 62264 и IEC 61512) |
|
|
Предоставляет возможность (enables) |
Предоставляет возможность на этапах ЖЦ (IEC 62890) |
|
Предоставляет возможность на уровнях иерархии (IEC 62264) |
Table 4
Subclasses of predicates of the RAMI 4.0 ontological model
Чтобы обеспечить актуальность онтологической модели и учёт лингвистически заданных разношкальных переменных, нужно обеспечить множество доменов возможностью их изменения с учетом динамических изменений состояний активов через временные метки с применением правил нечеткой логики. Например, домен "FieldDevice" может включать подмножества интеллектуальных переключателей и исполнительных механизмов, каждый из которых имеет свои атрибуты (напряжение, сила тока, температура, надежность) и связи с другими доменами (например, с "ControlDevice" через предикат "sendsDataTo"). Подход, при котором каждый домен служит источником прецедентной информации для анализа и принятия решений, позволяет структурировать данные в онтологии и поддерживать так называемые алгоритмы оценки близости прецедентов (Дли М. И., 2023).
При такой организации данных заказчик или производитель изделий, находящейся в экосистеме индустриальной цифровой платформы, может определить основные сведения о требуемой или производимой продукции, задав её лингвистическое описание, жизненный цикл, элементы изделия и связанные с ними элементы, согласно п. 4.1 стандартов IEC 63088 и ГОСТ 59799, включая средства и методы производства.
Такой набор концептов в сложной многомерной иерархии, элементы которого неоднозначно связаны друг с другом предикатами, относящимися к более чем к десяти классам, иллюстрирует сложность цифровых моделей элементов технических систем и показывает на сколько трудозатратно присвоить новому элементу киберфизической системы соответствующие координаты RAMI-куба. Задача усложняется тем, что эти элементы являются элементами базы данных различных ERP-систем предприятий, входящих в экосистему, могут быть заданы различными людьми в текстовом и лингвистическом формате.
На современном этапе развития больших языковых моделей (LLM) задачи наполнения баз знаний об элементах технических систем, образующих киберфизические системы под управлением промышленных цифровых платформ, могут решаться применением так называемых AI-ассистентов.
Разработка модели данных для реализации AI-ассистента
Для разработки модели данных и реализации функций AI-ассистента требуется связать ранее определённые функциональные блоки потоками данных, определив входные и выходные массивы данных для каждого блока и операции с массивами данных, осуществляемые на каждом этапе обработки информации, в соответствии с таб. 4.
При осуществлении функции a1 «Настройка AI-ассистента», её вход можно определить как A1 = P ∪ D1 (текст от пользователя и данные из мета-онтологии или стандартов), а выход как B1 = D2 ∪ D5 ∪ D3 (инициализация онтологии, категорий, тезауруса и текста). Если представить эту функцию, как a1: P × D1 → D2 × D5 × D3 то операции проекции и объединения в ней покажут массивы данных и их значения:
a1(p, d1) = (d20, d50, d30),
где d4 = p (прямое копирование текста), а d2я0, d50, d30 — начальные значения из D1.
При осуществлении функции a2 «Создание TF-IDF-векторов», её вход: A2 = D4 ∪ D5 ∪ D3 представляется в виде текста с описанием элементов, с отнесением к соответствующей категории в тезаурусе. Её выходы B2 = D3.1 – это векторные представления элементов из тезауруса. Если представить её функцию как a2: D4×D5×D3→D3.1, то операция интерпретации нечётких требований и преобразования текста в векторы с учётом тезауруса, в этой функции:
a2(d4, d5, d3) = d3.1,
где d3.1 — множество TF-IDF-векторов, полученных с использованием тезауруса для обогащения текста.
При осуществлении функции a3 «Классификация элементов» мы имеем вход: A3 = D3.1 в виде векторных представлений элементов из тезауруса и выход: B3 = D6, формирующий начальную классификацию этих элементов. Эту функцию можно представить как a3: D3.1 →D6 с операцией классификации a3(d3.1) = d60 , где d60 — множество пар (элемент, класс), определённых через сходство векторов (например, косинусное расстояние).
При осуществлении функций a5 «Определение координат по Hierarchy Levels», a6 «Определение координат по Integration Layers» и a4 «Определение координат по Life Cycle» их входами должны стать множества TF-IDF-векторов, полученных с использованием тезауруса для обогащения текста d3.1:
a4 : D3.1 → D6 : a4(d3.1) = {(e, c, (lc, ∅,∅), ∅) ∣ (e, c, ∅,∅) ∈ d6, lc = arg maxlc’ score(ve, lc′)};
a5 : D3.1 → D6 : a5(d3.1) = {(e, c, (lc, hl, ∅), ∅) ∣ (e, c, cl, ∅,∅) ∈ d6, hl = arg maxhl’ score(ve, hc′)};
a6 : D3.1 → D6 : a6(d3.1) = {(e, c, (lc, hl, il), ∅) ∣ (e, c, cl, hl, ∅) ∈ d6, il = arg maxil’ score(ve, il′)},
где score — функция сходства (например, косинусное расстояние), а выходами d6 становятся координаты и связи элементов по трём осям RAMI-куба:
В этом выражении e — это конкретный элемент или актив в системе, который представлен в множестве D6. Это может быть, например, физический объект (интеллектуальный переключатель, или другое устройство) или цифровая сущность (программное обеспечение), описываемый в рамках цифровой платформы или киберфизической системы. В контексте RAMI - e может быть идентификатором актива (например, «Sensor1» или «Controller2»), который проходит классификацию и привязку к координатам в трехмерной модели (жизненный цикл lc, уровень иерархии hl, слой интеграции il).
При осуществлении функции функций a7 «Интеграция в онтологическую модель» её входами становятся координаты и классификация элементов из массива D6, лингвистические отношения и семантические связи элементов из D3, а также элементы всей онтологической модели из D2, т.е. A7 = D6 ∪ D2 ∪ D3. При этом, выходами этой функции становятся те же массивы данных B7 = D2 ∪ D6 в обновлённом виде. Таким образом, эту функцию можно представить как a7: D6 × D2 × D3 → D2 × D6, в которой должны осуществляться операции объединения и преобразования: a7(d63, d2, d3) = (d′2, d64), где d′2 = d2 ∪ Integrate (d63, d3), а d64 — обновлённые данные с дополнительными связями.
После обновления данных в массивах D2 и D6 требуется произвести валидацию и проверку вновь внесённых данных на непротиворечивость данных. При осуществлении функции a8 (валидация и проверка) её вход можно интерпретировать как A8 = D6 ∪ D2 (координаты и онтология), а выход как: B8 = D6 ∪ D2 (проверенные данные, опционально исправленная онтология). Тогда функция: a8: D6 × D2 → D6 × D2 осуществляет операцию фильтрации и коррекции: a8 (d64, d′2) = (d65, d′′2), где d65 — проверенные данные, а d′′2 = d′2 или d′2 ∪ Correct(d64, d′2) при необходимости.
Для функции a9: (представление результатов) входом является A9 = D6 (проверенные координаты), а выходом: B9 = D7 ∪ R (визуализированная онтология для вывода пользователю). В функции a9 : D6 → D7 × R выполняется операция преобразования: a9 (d65) = (d7, r), где d7 — визуализированная онтология, а r — информация для пользователя.
Если пользователь по результатам анализа визуализированных данных принимает решение об уточнении модели, то он набирает входные данные A10 для функции a10 (уточнение модели). При этом вход этой функции: A10 =P (обратная связь пользователя), а выход: B10 = D3 (обновлённый тезаурус). Таким образом функция: a10 : P → D3 выполняет операцию обновления: a10(p) = d′3, где d′3 = d3 ∪ Update(p) d, а затем инициирует возврат d′3→a2.
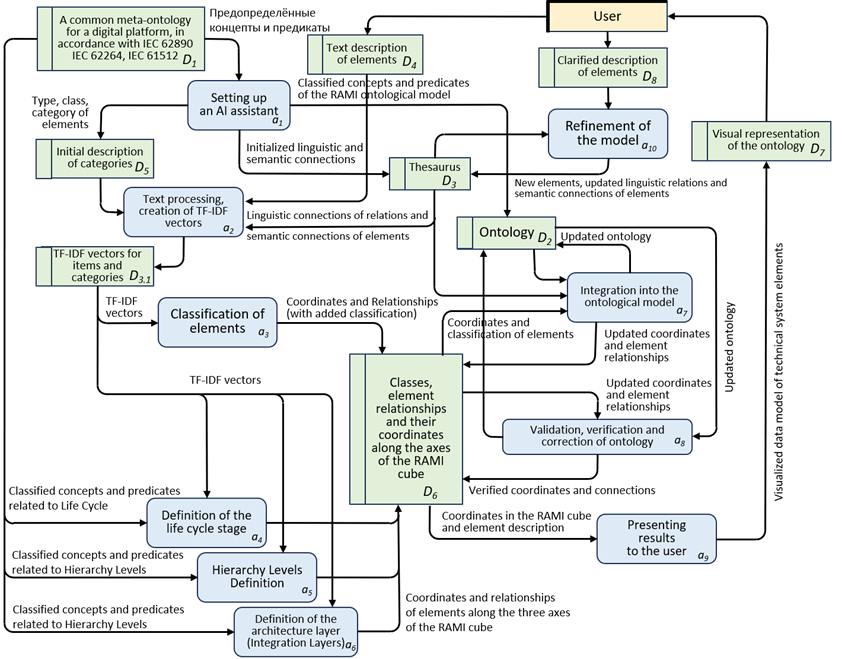
По результатам вышеописанного теоретико-информационного анализа была разработана структура данных AI-ассистента для интеллектуального управления референтной моделью RAMI 4.0 (рис. 3).
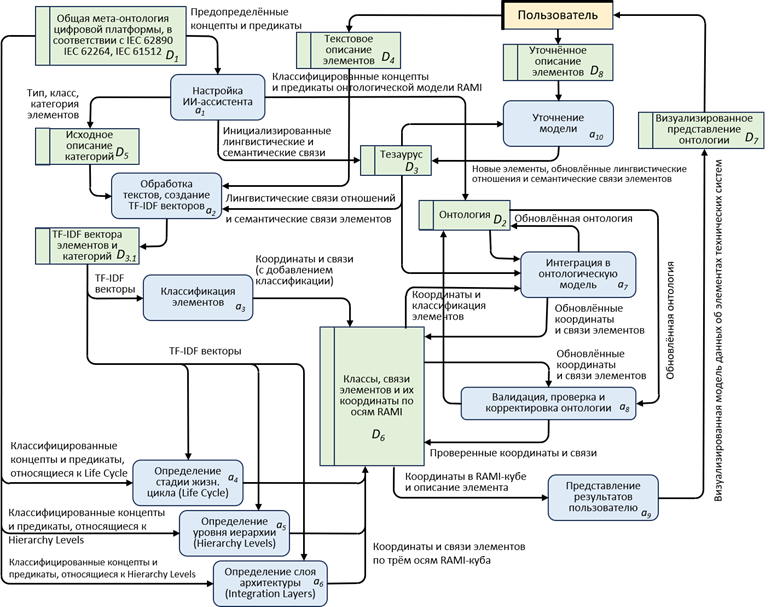
Рис. 3. Структура данных AI-ассистента для интеллектуального управления референтной моделью RAMI 4.0 в нотации DFD
В разработанной модели для осуществления функций a8 и a10 ИИ-ассистент может применять различные методы оптимизации, в зависимости от инструментов, на которых он реализовывается. Самый подходящий метод, при этом, является итеративный метод решения задач и вычислений, который заключается в последовательном применении одной или нескольких операций (шагов) к начальному значению, чтобы постепенно приближаться к желаемому результату. Этот метод можно применить, используя стандартные библиотеки Python в платформе Google Colab. Применив этот метод оптимизации в функциях a8 и a10, на каждом шаге результат предыдущей итерации будет использоваться как входное значение для следующей.
Итеративный процесс помогает определить фиксированные точки с устойчивым состоянием системы, что важно в моделировании динамических систем, в управлении киберфизическими системами по RAMI 4.0, где состояния активов эволюционируют.
Если S = D1 ∪ D2 ∪ D3.1 ∪ D3 ∪ D4 ∪ D5 ∪ D3.1 ∪ D6 ∪ D7 — множество состояний системы, состоящее из разных массивов данных, которые необходимо обрабатывать ИИ-ассистенту, то итерация St+1 формирует композицию функций F посредством итерации:
St+1 = F(St, a10(P)).
При этом функция a10 должна обновить массив данных D3, и процесс должен возвратиться к функции обработки текстов для создания TF-IDF-векторов a2.
Информационная система, осуществляющая добавление новых активов и объектов и обновление связей достигает фиксированной точки, если St+1 = St. В этом случае D3 перестаёт обновляться (обратная связь завершена). Т.е., формально:
S∗ = fix (F), где fix(F)={S ∣ F(S) = S}.
Если пользователь вносит конечное множество уточнений P в функции a10 и, при этом, инициализированные лингвистические и семантические связи, созданные функцией a1 тоже конечно, то процесс сходится за конечное число итераций. Метрика сходимости при этом dist(St, St+1) = ∣D3t+1∖D3t∣, а сходимость достигается, когда dist(St, St+1) = 0, что фиксируется функцией a8.
При разработке структуры данных для реализации ИИ-ассистента были определены и апробированы инварианты для проверки корректности:
-
-Инвариант 1- Сохранение исходного текста:
∀t : D4t = D40, где D40 — начальное множество текстов.
-
-Инвариант 2 - Соответствие координат и онтологии:
∀(e,c,(lc,hl,il), r) ∈ D6t: ∃ (e, hasLifeCycleStage, lc) ∈ D2t
-
-Инвариант 3 - Монотонное обновление тезауруса:
∀t : D3t ⊆ D3t+1.
При апробации, инвариант 1 обеспечивал гарантию целостности, проверяя, что исходные данные не искажаются. Инвариант 2 контролировал согласованность структуры RAMI 4.0 и онтологии D2. Инвариант 3 гарантировал монотонность развития тезауруса D3, контролируя, что развитие ведётся только путем добавления новых связей, что важно для стабильности модели. Применённая в функции a8 операция IsCorrect призвана выполнять проверку инвариантов 1, 2 и 3. Она была реализована в ИИ-ассистенте как часть итеративного процесса валидации и корректировки, чтобы обеспечить корректность онтологической модели на каждой итерации. В таб. 5 собраны методы и инструменты, которыми были реализованы различные функции ИИ-ассистента.
Таблица 5
Методы и инструменты, которыми были реализованы функции AI-ассистента
|
Функции AI-ассистента |
Выполняемые действия |
Методы и инструменты для реализации функций |
|
|
a1 |
Настройка AI-ассистента |
Инициализация среды, загрузка мета-онтологии |
Python, OWL API, Protégé, Google Colab |
|
a2 |
Создание TF-IDF-векторов |
Преобразование текста в векторные представления |
Scikit-learn (TF-IDF), NLTK, Python |
|
a3 |
Классификация элементов |
Определение типа элемента (PhysicalAsset и т.д.) |
Косинусное сходство, кластеризация (K-means), Python |
|
a4 |
Определение координат |
Привязка к этапам жизненного цикла |
Логика разметки OWL, семантический анализ |
|
a5 |
Определение координат по Hierarchy Levels |
Привязка к уровням иерархии |
Логика разметки OWL, RDF-графы |
|
a6 |
Определение координат по Integration Layers |
Привязка к слоям интеграции |
Логика разметки OWL, семантический анализ |
|
a7 |
Интеграция в онтологическую модель |
Добавление элемента и предикатов в онтологию |
OWL API, SPARQL, RDF-обновление |
|
a8 |
Валидация и проверка |
Проверка корректности и инвариантов |
Итеративная валидация, логические правила (SWRL) |
|
a9 |
Представление результатов |
Визуализация онтологии для пользователя |
Graphviz, D3.js, Google Colab (визуализация) |
|
a10 |
Уточнение модели |
Обновление тезауруса по обратной связи |
NLP (NLTK), итеративное обучение, Python |
Table 5
Methods and tools used to implement the AI assistant's functions
Результаты исследований и разработки ИИ-ассистента
Проведённые исследования структуры знаний, соответствующих требованиям RAMI позволили создать прототип ИИ-ассистента и апробировать модель двунаправленного интеллектуального информационного обмена между корпоративными ERP-системами участников индустриальной экосистемы и центральной онтологией индустриальной цифровой платформы (ИЦП), построенной в соответствии с референтной архитектурной моделью RAMI 4.0.
Ключевым результатом исследования стало создание механизма, позволяющего автоматически формировать и актуализировать элементы баз знаний платформы на основе данных, поступающих из локальных ERP-систем, а также обратно — предлагать и создавать новые объекты в ERP на основе обновлений в онтологии ИЦП. Центральными компонентами системы обмена выступают:
- центральная информационная система ИЦП,
- корпоративная ERP-система участника,
- ИИ-ассистент, выполняющий семантическую обработку, классификацию и валидацию.
Модель бизнес-процесса информационного обмена представлена на рисунке 4 (для сценария создания нового элемента в ERP).
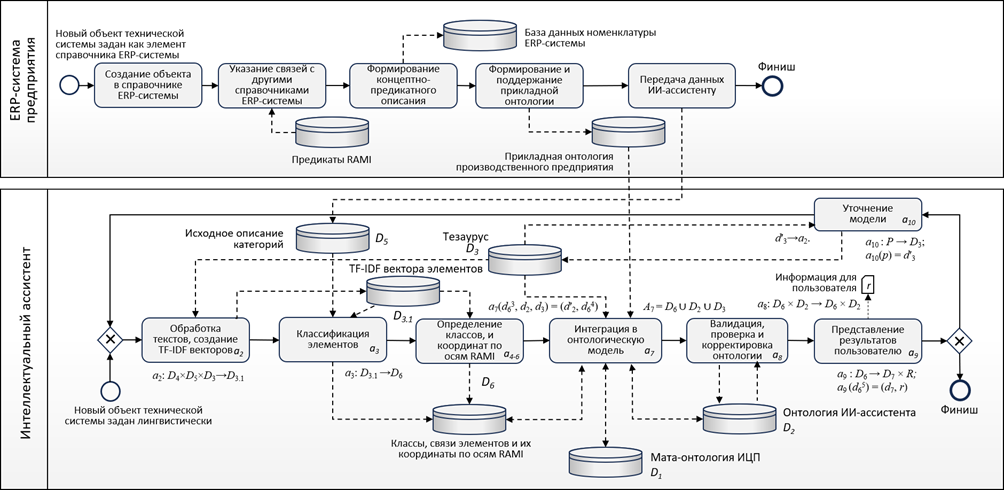
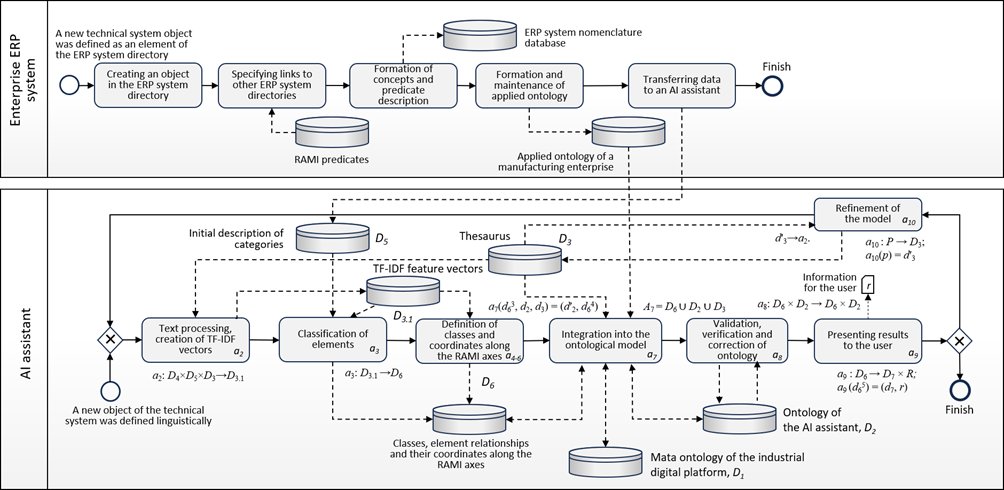
При создании нового элемента технической системы (оборудование, материал, узел и т.п.) в ERP-системе оператор выполняет стандартные действия:
-
создаёт/выбирает объект в справочнике «Номенклатура» (или аналогичном),
-
указывает связи с другими объектами через предикаты из специализированного справочника «Предикаты RAMI».
Если описание объекта задано на естественном языке (в поле технического описания или комментария), ИИ-ассистент автоматически выполняет полный цикл обработки, описанный в разделе «Функции ИИ-ассистента для ввода данных в референтную модель RAMI 4.0». Таким образом, обеспечивается автоматическое создание и интеграция нового элемента базы знаний платформы без ручного ввода координат и связей.
При появлении нового элемента в онтологии ИЦП (в результате действий других участников экосистемы или аналитиков платформы) автоматически инициируется:
-
рассылка уведомлений участникам в форматах TXT или XML,
-
интерпретация ИИ-ассистентом параметров элемента (координаты RAMI, связи, предикаты, атрибуты),
-
проверка уникальности в локальной базе предприятия,
-
автоматическое формирование предложения по созданию соответствующего объекта в ERP-системе.
Это даёт возможность оператору ERP-системы оценить готовое предложение с заполненными видом номенклатуры значениями по осям RAMI, набором предикатов для связей. После подтверждения или корректировки оператором предложенной информации, он запускает процедуру создания нового объекта в базе данных ERP, который может быть включён в состав цифровой модели изделия, предприятия или производственного процесса.
Для практической реализации двунаправленного обмена данными была разработана оригинальная конфигурация ERP-платформы «1С: Предприятие». Основными новациями в этой конфигурации стали:
-
дополнительный справочник «Предикаты RAMI», который содержит предикаты онтологической модели с привязкой к осям RAMI 4.0 и реквизитами (тип связи, обязательность и др.).
-
дополнительный справочник «Свойства RAMI» — позволяет оператору (или автоматически) указывать значения по трём осям модели при создании/редактировании объекта номенклатуры.
Интеграция структуры данных ERP-системы предприятия с базой знаний цифровой платформы осуществляется через внешние обработки или веб-сервисы. Выгрузка данных из 1С → передача ИИ-ассистенту → возврат обогащённых триплетов и координат RAMI → запись в дополнительные реквизиты объектов 1С. Обратный поток: приём уведомлений от цифровой платформы → интерпретация ИИ-ассистентом → предложение создания объекта в 1С.
Предложенный подход позволяет полностью автоматизировать извлечение концептов и связей из неструктурированных лингвистических описаний, присвоение координат RAMI без ручного вмешательства с низкой вероятностью ошибки, создание и синхронизацию элементов баз знаний как в локальных ERP, так и в центральной онтологии платформы.
Апробация на синтетических и частично реальных данных показала, что ИИ-ассистент способен автоматически формировать корректные элементы баз знаний в 75–85 % случаев (при описаниях средней сложности), значительно сокращая время и трудозатраты на интеграцию данных в экосистему «Индустрии 4.0».
Обсуждение результатов
Главными результатами проведённого исследования и разработанного на его основе прототипа интеллектуального ассистента стало онтологическое описание референтной модели RAMI 4.0, в соответствии со стандартами ГОСТ Р 59799 и IEC 62890, которое позволяет применять положения этих стандартов с помощью популярной платформы «1С: Предприятие». Полученные результаты полностью подтверждают основную гипотезу исследования: интеллектуальная классификация элементов производственных активов, автоматическое определение их координат в многомерном RAMI-кубе и валидация на основе онтологических моделей позволяют автоматизировать создание и актуализацию баз знаний о киберфизических системах в индустриальных цифровых платформах, повышая эффективность управления распределёнными экосистемами «Индустрии 4.0». Дополнительные гипотезы также нашли подтверждение: использование TF-IDF-векторизации в сочетании с тезаурусом и элементами нечёткой логики обеспечивает надёжную обработку неструктурированных лингвистических описаний (точность автоматической классификации и привязки к осям RAMI достигла 75–85 % на тестовых наборах), а двунаправленный обмен данными между ERP-системами и центральной онтологией платформы реализуем без нарушения целостности знаний.
Разработанный прототип ИИ-ассистента демонстрирует значительное сокращение трудозатрат: добавление нового элемента в базу знаний экосистемы (присвоение RAMI-координат), ранее требовавшее 12–25 минут ручной работы высоко квалифицированного аналитика, теперь занимает 18–45 секунд. Операция может выполняться в автоматическом режиме под контролем оператора низкой квалификации. Это согласуется с общим трендом цифровизации, где семантические технологии и онтологии выступают ключевым инструментом для преодоления гетерогенности данных в киберфизических системах.
Сходство проведённого исследования с результатами других исследований проявляется в использовании онтологического подхода для представления активов и процессов в рамках RAMI 4.0. В публикациях IEEE, в частности в (Awad 2016) подчёркивается роль формальных онтологий как семантической основы для обмена данными между интеллектуальными устройствами и системами, что полностью соответствует предложенному в настоящем исследовании решению с использованием мета- и прикладных онтологий.
Аналогично, в исследованиях (Bousdekis, 2021) и (Yahya, 2021) акцент делается на построении «графов знаний» на базе RAMI 4.0 для обеспечения интероперабельности и поддержки принятия решений в условиях больших данных. Предложенное техническое решение развивает эти идеи, добавляя автоматизированную обработку естественного языка и двунаправленную синхронизацию с корпоративными ERP-системами.
Кроме того, большинство существующих отечественных и зарубежных решений (например, OntoMat 4.0 или InPro ontology) фокусируются либо на статическом представлении знаний, либо на интеграции уже структурированных данных, не предлагая решений по автоматическому извлечению концептов из произвольных текстовых описаний объектов знаний. Предложенный в настоящем исследовании механизм предварительной обработки (лемматизация + TF-IDF + тезаурус) с последующим определением координат RAMI через векторное сходство и онтологический вывод позволяет обрабатывать реальные, часто неидеальные описания активов, вводимые персоналом без специальной подготовки. Это расширяет применимость подхода в реальных географически распределённых консорциумах, где данные поступают от разных предприятий в разнородных форматах.
Достигнутый уровень автоматизации, сокращение времени, повышение точности, открывают перспективы для дальнейшего развития: интеграция больших языковых моделей (LLM) для улучшения интерпретации сложных технических текстов, добавление динамических аспектов (временные метки, нечёткие состояния активов) и масштабирование на межотраслевые экосистемы («экострии» и «экосиполии»).
Заключение
В результате проведённого исследования разработана онтологическая модель базы знаний для референтной архитектурной модели RAMI 4.0, формализованы ключевые функции ИИ-ассистента по автоматизированному вводу, классификации, определению координат в RAMI-кубе и валидации элементов производственных активов. Создана структура данных и реализован прототип ИИ-ассистента на платформе Google Colab, обеспечивающий двунаправленный интеллектуальный обмен между ERP-системой «1С: Предприятие» и центральной онтологией индустриальной цифровой платформы. Полученные результаты полностью подтверждают выдвинутую гипотезу: интеллектуальная обработка лингвистических описаний производственных активов, технических систем и их элементов с использованием TF-IDF-технологии, тезауруса и онтологического вывода позволяет автоматизировать создание и актуализацию баз знаний о киберфизических системах, существенно повышая эффективность управления распределёнными экосистемами «Индустрии 4.0».
Значимость работы заключается в преодолении барьеров гетерогенности данных и ручного труда при интеграции активов в многомерную модель RAMI 4.0, что особенно актуально для географически распределённых предприятий и консорциумов в условиях ускоренной цифровой трансформации. Предложенный подход решает поставленные цели: автоматизация ввода данных в индустриальные цифровые платформв и поддержка актуальности знаний в распределённых экосистемах.
Полученные результаты открывают перспективы для решения более сложных междисциплинарных задач: обеспечение семантической интероперабельности в глобальных цепочках поставок, поддержка автономных киберфизических систем с элементами самоорганизации, а также интеграция с цифровыми двойниками и генеративными ИИ-моделями для прогнозирования состояний активов.
Перспективы дальнейшей работы включают: интеграцию больших языковых моделей (LLM) для повышения точности интерпретации сложных технических текстов, внедрение динамических аспектов (временные метки, нечёткие состояния активов с использованием расширенной нечёткой логики), полномасштабное тестирование в реальных географически распределённых производственных предприятиях.
Ограничения. Исследование имеет ряд ограничений, которые следует учитывать при обобщении и практическом применении полученных результатов.
1) Отсутствие полномасштабного тестирования на реальных производственных данных
Апробация прототипа ИИ-ассистента проводилась преимущественно на синтетических наборах данных (описания оборудования и материалов, сгенерированные на основе типовых технических паспортов и стандартов) и ограниченном объёме реальных описаний (45 записей из открытых источников и партнёрских предприятий). Это не позволяет в полной мере оценить устойчивость алгоритмов к реальному разнообразию стилей описаний, профессиональному жаргону, ошибкам операторов и очень большим объёмам данных, характерным для действующих производственных консорциумов.
2) Отсутствие оценки в условиях реального времени и высокой нагрузки
Прототип реализован на платформе Google Colab и не подвергался нагрузочному тестированию (одновременная обработка сотен/тысяч запросов от разных предприятий, обработка в реальном времени при частоте обновлений активов 1–10 в минуту).
3) Зависимость от качества тезауруса и мета-онтологии
Точность автоматической интерпретации лингвистических описаний (75–85 % в тестовых наборах) сильно зависит от полноты и актуальности унифицированного тезауруса и мета-онтологии RAMI 4.0. В реальных экосистемах с отраслевой спецификой (машиностроение, нефтехимия, энергетика и др.) потребуется постоянное расширение и поддержка этих словарей, что не было предметом настоящего исследования.
4) Отсутствие соответствия требованиям информационной безопасности
Прототип без учёта требований к промышленной кибербезопасности (IEC 62443, ГОСТ Р 56939 и пр.). Обмен данными между ERP и ИЦП через внешние обработки и веб-сервисы потенциально создаёт уязвимости, которые требуют отдельного анализа и мер защиты.
5) Ограниченная поддержка динамических и нечётких состояний активов
Хотя в прототипе использованы элементы нечёткой логики для обработки неопределённостей в описаниях, полноценный учёт динамических характеристик (изменение состояний активов во времени, деградация, переход между стадиями жизненного цикла) реализован лишь частично и требует дальнейшей разработки.
Указанные ограничения не уменьшаю значимости полученных результатов как концептуальной и прототипной основы, но подчёркивают необходимость последующих этапов: полномасштабного пилотного внедрения в реальных производственных экосистемах, нагрузочного тестирования и проверку на безопасность, расширения на другие ERP-платформы и интеграции с современными большими языковыми моделями для повышения робастности обработки текстов
Limitations. The study has several limitations that should be considered when generalizing and applying the results in practice.
1) Lack of full-scale testing on real production data
The AI assistant prototype was validated mainly on synthetic datasets (equipment and material descriptions generated from typical technical passports and standards) and a limited set of real descriptions (45 records from open sources and partner enterprises). This does not allow a full assessment of algorithm robustness to real-world variability in description styles, domain-specific jargon, operator errors, and very large data volumes typical of operating production consortia.
2) No evaluation under real-time and high-load conditions
The prototype was developed on Google Colab and has not undergone stress testing (simultaneous processing of hundreds/thousands of requests from different enterprises, real-time processing at asset update rates of 1–10 per minute). Performance, latency, and resource consumption in an industrial environment remain unknown.
3) Dependence on the quality of the thesaurus and meta-ontology
The accuracy of linguistic description interpretation (75–85% in test sets) strongly depends on the completeness and currency of the unified thesaurus and RAMI 4.0 meta-ontology. In real ecosystems with industry-specific features (mechanical engineering, petrochemicals, electronics, etc.), continuous expansion and maintenance of these dictionaries will be required, which was not addressed in the present study.
4) Lack of certification and compliance with information security requirements
The prototype has not been certified for compliance with industrial cybersecurity standards (IEC 62443, GOST R 56939, FSTEC requirements for critical information infrastructure protection). Data exchange between ERP and ICP via external processing and web services potentially creates vulnerabilities that require separate analysis and protective measures.
5)Limited support for dynamic and fuzzy asset states
Although elements of fuzzy logic were used in the prototype to handle description uncertainties, full accounting of dynamic characteristics (changes in asset states over time, degradation, transitions between life cycle stages) is implemented only partially and requires further development.
These limitations do not diminish the significance of the obtained results as a conceptual and prototypical foundation, but highlight the need for subsequent stages: full-scale pilot implementation in real production ecosystems, load and security testing, extension to other ERP platforms, and integration with modern large language models to improve text processing robustness.
1 Правительство РФ, О Стратегии развития информационного общества в Российской Федерации на 2017–2030 годы: Указ Президента РФ № 203 от 09.05.2017. Собрание законодательства Российской Федерации от 15.05.2017. № 20. 2901 с.
2 DIN SPEC 91345:2016-04. Referenzarchitekturmodell Industrie 4.0 (RAMI 4.0).
3 Росстандарт. ГОСТ Р 59799-2021. Умное производство. Модель эталонной архитектуры индустрии 4.0 (RAMI 4.0).