Введение
В последние годы методы машинного обучения и глубоких нейронных сетей получили широкое распространение в задачах анализа и распознавания сигналов. Такие методы применяются для обработки различных типов временных данных, включая радиосигналы, телеметрические данные, акустические сигналы и другие виды информационных потоков. Основной задачей подобных систем является выявление закономерностей в структуре сигналов и их последующая классификация или идентификация.
Наиболее распространённым подходом к решению задач распознавания является использование нейросетевых классификаторов, в которых модель обучается напрямую сопоставлять входной сигнал с одним из заранее заданных классов (Хайкин, 2008). В рамках данной парадигмы нейронная сеть одновременно выполняет извлечение признаков и принимает окончательное решение о принадлежности сигнала к определённой категории.
Несмотря на высокую эффективность такого подхода во многих прикладных задачах, он обладает рядом фундаментальных ограничений, одним из которых является предположение о наличии фиксированного набора классов, известных на этапе обучения модели (Geng et al., 2021; Oza, Patel, 2019; Scheirer et al., 2013;). В реальных же условиях эксплуатации систем распознавания данное предположение часто не выполняется. Среда может содержать сигналы, отсутствующие в обучающей выборке, а состав объектов наблюдения может изменяться со временем. В таких ситуациях классические классификационные модели оказываются вынуждены относить неизвестные сигналы к одному из известных классов, что приводит к ошибочным решениям и снижению надёжности системы (Bendale, Boult, 2016; Oza, Patel, 2019). Другой важной особенностью традиционных архитектур является жесткая интеграция процессов формирования признакового представления и принятия решения. Нейронная сеть выступает одновременно в роли экстрактора признаков и классификатора, что делает систему монолитной и затрудняет её модификацию, а добавление новых объектов, изменение критериев принятия решения или адаптация системы к новым условиям часто требует повторного обучения всей модели.
В связи с этим представляет интерес альтернативный подход к построению систем распознавания сигналов, основанный на разделении процессов формирования признакового представления и принятия решения. В рамках такого подхода нейронная сеть используется исключительно для извлечения устойчивых признаковых описаний сигналов, тогда как процедура идентификации реализуется отдельным алгоритмическим модулем. Это позволяет интерпретировать задачу распознавания не как задачу прямой классификации, а как задачу анализа взаимного расположения признаковых описаний сигналов в некотором метрическом пространстве.
В настоящей работе предлагается архитектурный подход к обработке сигналов, основанный на формировании компактных векторных представлений и последующем анализе их взаимного расположения в метрическом пространстве. Предполагается, что сигналы одного источника формируют устойчивые области в пространстве признаков, что позволяет рассматривать соответствующие векторы как идентификационные «отпечатки» источников сигналов (Воронцов, 2025). В этом случае задача распознавания сводится к определению степени сходства между признаковыми представлениями сигналов и анализу их геометрических отношений (Hassen, Chan, 2020).
Предлагаемый подход реализует переход от классификационной парадигмы распознавания к идентификационной, в которой объектом анализа становится не принадлежность сигнала к заранее заданному классу, а его положение в пространстве признаковых представлений. Научная новизна работы заключается в формировании архитектурного принципа построения систем распознавания сигналов, основанного на разделении процессов обучения представлений и принятия решений, а также на геометрической интерпретации задачи идентификации в латентном пространстве признаков.
В рамках данной парадигмы нейросетевая модель используется для построения устойчивого латентного пространства эмбеддингов, тогда как процедура идентификации реализуется посредством анализа расстояний между эмбеддингами и эталонными прототипами. Такое разделение повышает гибкость системы и позволяет применять её в условиях открытого множества, где состав наблюдаемых объектов может изменяться во времени.
В работе получены следующие основные результаты:
- Предложена архитектурная парадигма построения систем распознавания временных сигналов, основанная на разделении процессов формирования признакового представления и принятия решения.
- Разработан подход к представлению временных сигналов в виде компактных векторных описаний, формируемых нейронной сетью и отражающих устойчивые структурные характеристики источника сигнала.
- Предложена геометрическая интерпретация задачи идентификации временных сигналов в пространстве признаков.
- Сформулирована концепция идентификационных признаковых «отпечатков» временных сигналов, формирующих устойчивые области в пространстве признаков.
- Показана возможность построения систем распознавания, корректно функционирующих в условиях появления ранее неизвестных сигналов.
Статья организована следующим образом: в следующем разделе осуществляется математическая постановка задачи, далее описывается предлагаемая архитектура формирования латентного пространства и принципы построения идентификационных представлений временных сигналов, затем рассматривается геометрическая интерпретация процесса распознавания и структура модуля принятия решений. В заключении обсуждаются свойства предлагаемого подхода и направления дальнейших исследований.
Математическая постановка задачи
Пусть имеется временной сигнал x(t), принадлежащий некоторому источнику или объекту S. Классическая постановка задачи предполагает отображение:
где Ci – фиксированные классы, N – количество классов.
В предлагаемой постановке вводится промежуточное представление:
где f(x) – функция эмбеддинг-преобразования, z – векторное представление сигнала (эмбеддинг) в латентном пространстве R размерности k.
Решение об идентификации принимается внешним механизмом принятия решений:
где P – множество прототипов (эталонов), соответствующих количеству классов N, id – идентифицированный объект, unknown – неизвестный объект.
Соответственно, архитектура системы разделяется на два независимых уровня:
• уровень представления (2);
• уровень принятия решений (3).
В рамках предлагаемого подхода каждый сигнал интерпретируется не как экземпляр класса, а как источник устойчивого идентификационного паттерна – цифрового «отпечатка» сигнала - не класса и не категории, а устойчивого векторного образа, формируемого нейросетью, который отражает индивидуальные структурные характеристики источника сигнала. Таким образом задача системы сводится не к ответу на вопрос «что это?», а к ответу на «к кому это ближе?».
Поскольку, с практической точки зрения, данная логика принципиально ближе к биометрии, радиочастотной идентификации и задачам радиоразведки, нежели к классическому распознаванию образов, то в дальнейшем в качестве конкретного примера будем использовать задачу идентификации радиосигналов.
В классических задачах классификации радиосигналов объекты распознавания обычно рассматриваются как отдельные сигнальные события (импульсы, пакеты, фреймы), которые классифицируются независимо друг от друга на основе их локальных параметров (частота, длительность, амплитуда, форма, спектральные характеристики и т.д.) (Рембовский, 2012).
Однако в реальных радиочастотных средах источник сигнала (передатчик, излучатель, устройство) представляет собой динамический процесс, генерирующий последовательность взаимосвязанных сигналов во времени. Поведение источника определяется не только параметрами отдельных импульсов, но и их временной структурой, включая интервальные зависимости, ритмику передачи, вариативность параметров, повторяемость паттернов и корреляции между параметрами.
Таким образом, идентификация источника сигнала должна рассматриваться не как классификация отдельных событий, а как распознавание временного процесса, формируемого данным источником.
Пусть поток радиосигналов представлен в виде временного ряда событий:
где n – размер имеющегося массива данных, а каждое событие ei описывается вектором признаков:
где d – количество признаков (например: частота, длительность импульса, межимпульсный интервал, временная метка и т.д.).
Вместо обработки отдельных событий, формируется представление в виде последовательностей фиксированной длины с использованием «скользящего окна» (sliding window):
где T - длина «скользящего окна».
Таким образом, исходный временной ряд (4) преобразуется в последовательность тензоров:
что позволяет моделировать временную структуру сигналов, а не только их локальные характеристики.
В отличие от классической классификации, базирующейся на предположении о замкнутом множестве, система должна работать в условиях open-set («распознавание открытого множества») в среде, где возможно появление сигналов от ранее неизвестных источников. В такой постановке целевая задача формулируется как идентификация источника сигнала:
Из постановки задачи вытекают следующие фундаментальные требования:
- Последовательностная природа обработки - обработка должна учитывать временные зависимости между сигналами.
- Инвариантность к локальным шумам - система должна быть устойчива к вариациям отдельных импульсов.
- Формирование компактного представления источника - источник должен кодироваться в виде устойчивого вектора признаков.
- Идентификация на основе сходства - решение должно приниматься на основе близости в пространстве признаков, а не только вероятностной классификации.
- Поддержка распознавания в условиях открытого множества - система должна уметь выявлять ранее неизвестные источники.
Таким образом, мы переходим от классификации сигналов к идентификации источников сигнала как динамических процессов, где исходные данные рассматриваются как поток событий, а не как непрерывный сигнал во временной области. Каждое событие соответствует отдельному радиоимпульсу (или сигнальному фрагменту), описываемому набором параметров, полученных на этапе первичной обработки сигналов (детектирование, параметризация, извлечение признаков).
Отметим, что переход к интерпретации сигнала как временного процесса позволяет формализовать задачу идентификации в терминах анализа последовательностей, что требует использования моделей, работающих с динамическими контекстами.
В рамках данной статьи предлагается подход, базирующийся на методах машинного обучения и прежде, чем перейти к деталям архитектуры, определим входные данные системы на конкретном примере.
Пусть каждое событие, например, представляется в виде вектора (5):
где fi - частотная характеристика, di - длительность импульса, pi - межимпульсный интервал, ti - временная метка события.
Такое представление соответствует реальным архитектурам систем радиомониторинга, где первичные сигналы уже преобразованы в табличное параметрическое описание.
Для моделирования временной структуры сигнального процесса применим предложенный выше метод «скользящего окна» - последовательности формируются в соответствии с (5, 6), вследствие чего исходный временной ряд преобразуется в множество, которое можно рассматривать как набор обучающих примеров:
Каждая последовательность Wj интерпретируется не как набор независимых импульсов, а как локальный фрагмент поведения источника yj во времени.
Это позволяет модели обучаться корреляциям между параметрами, временным паттернам, повторяемым структурам, ритмике передачи, а также динамике изменения параметров, вследствие чего признаки приобретают процессную семантику, а не событийную (рис. 1), что переводит задачу из пространства статической классификации в пространство моделирования динамических процессов.
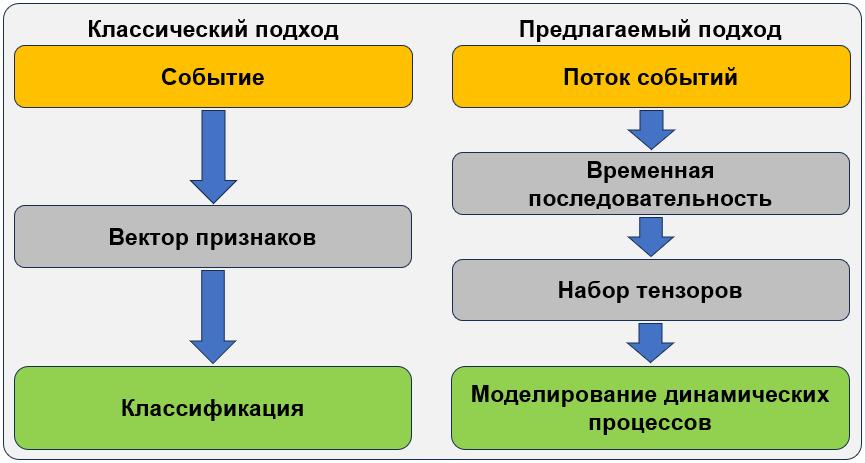
Такое представление данных делает возможным использование моделей, ориентированных на временную структуру, таких как сверточные одномерные и рекуррентные сети, что создаёт основу для построения универсального представления источников сигналов в виде компактных эмбеддинг-векторов.
Архитектура системы идентификации и распознавания на основе временных последовательностей
Предлагаемая система построена по принципу разделения функций между уровнями обработки:
- формирование последовательностей сигналов;
- извлечение структурных паттернов;
- моделирование временной динамики;
- формирование эмбеддингов;
- идентификация на основе сходства.
Архитектура предлагаемой модели не является монолитным классификатором, а представляет собой модульную систему, состоящую из:
- последовательностного энкодера;
- латентного пространства, создаваемого этим энкодером;
- модуля принятия решения, работающего в этом латентном пространстве на основе геометрической логики.
Последовательностный энкодер строится на основе нейросетевой модели (Sainath et al., 2015; Wang, 2025) и предназначен для преобразования входного тензора в компактное векторное представление:
где z – эмбеддинг (отпечаток) источника.
Сверточный одномерный слой (Conv1D) используется для выявления локальных временных структур:
Он выполняют функцию фильтрации сигнала во временной области и позволяет обнаруживать повторяющиеся фрагменты, локальные зависимости, характерные микро-паттерны, корреляции между признаками в малых временных окнах (Карелина и др., 2025; Муаамар, Круглова, 2026). Другими словами, Conv1D-слой выполняет роль адаптивного цифрового фильтра.
Рекуррентный слой (LSTM) используется для моделирования долгосрочных временных зависимостей:
LSTM-слой моделирует поведение источника как процесс и позволяет нейросети учитывать ритм передачи, периодичность, временную структуру, вариативность паттернов, а также зависимости текущих сигналов от предыдущих (Карелина и др., 2025; Муаамар, Круглова, 2026).
Полносвязный слой (Dense) формирует компактное векторное представление фиксированной размерности:
Именно этот вектор и интерпретируется как эмбеддинг (отпечаток) источника сигнала (Schroff et al., 2015), отражающий устойчивые структурные характеристики генерируемого им сигнального процесса.
Латентное пространство Rk появляется в момент перехода от высокоразмерных временных последовательностей (W) к компактному вектору признаков (z). Физически происходит сжатие данных: Conv1D- и LSTM-слои извлекают физические инварианты, а Dense-слой проецирует их в многомерный вектор. Это «сырое» латентное пространство, где близость объектов еще не гарантирована, однако уже даже оно обладает следующими свойствами:
- предполагается, что сигналы одного источника формируют относительно компактные кластеры;
- разные источники разделяются в латентном пространстве;
- расстояние между эмбеддингами отражает сходство поведения источников.
Формально норма похожести источников (их сходство) описывается соотношением:
Такой подход переводит задачу из вероятностной классификации в геометрию пространства признаков: вместо классического softmax-классификатора используется метрическое сопоставление, а идентификация осуществляется на основе:
где similarity - это функция, которая определяет, насколько близки друг к другу два вектора, z – эмбеддинг входной последовательности, ci - прототип (эталон) i-го источника.
Еще одним элементом архитектуры является радиально-базисный слой (RBF) (Broomhead, Lowe, 1988), который выполняет роль «архитектора метрики», поскольку в обычной сети пространство признаков может быть аморфным, а RBF-слой накладывает на него радиально-базисную топологию.
Для вычисления похожести используется радиально-базисная функция:
где ci - центр (прототип), γ - параметр чувствительности.
Соответственно, каждый нейрон RBF-слоя определяет «центр притяжения» (прототип) в латентном пространстве. В процессе обучения градиенты от RBF-слоя заставляют энкодер (CNN+LSTM) группировать эмбеддинги похожих сигналов в компактные гиперсферы вокруг этих центров. Подобный подход к разделению признакового пространства на гиперсферические подобласти позволяет эффективно классифицировать сигналы со сложной частотно-временной структурой даже в условиях априорной неопределенности (Коротков, Батчев, 2022; Коротков, Зырянов, 2017). Таким образом, RBF-слой интерпретируется как мягкий классификатор по расстояниям, где близкие (с малым евклидовым расстоянием) эмбеддинги дают высокую активацию, а удалённые - подавляются экспоненциально. Это формирует метрически структурированное латентное пространство, пригодное для надежной идентификации и детектирования аномалий (Amirian, Schwenker, 2020).
Для каждого известного источника определяется прототип (эталонный сигнал источника):
где zij - эмбеддинги сигналов i-го источника.
Таким образом, cj интерпретируется как центроид кластера j-го источника в латентном пространстве и позволяет сформировать эталонную базу сигналов источников в латентном пространстве:
Решение принимается на основе расстояний в латентном пространстве:
с дополнительным пороговым контролем:
где τ - порог неизвестности.
Соответственно, система логически разделяется на уровни:
- Уровень (слой) извлечения признаков (параметризация сигналов).
- Уровень (слой) моделирования временной структуры.
- Уровень (слой) создания эмбеддинга источника.
- Уровень (слой) сопоставления эмбеддинга с известными прототипами.
- Уровень (слой) идентификации неизвестных источников.
Таким образом, предлагаемая система представляет собой многоуровневую архитектуру обработки сигналов, в которой нейросетевая модель выступает лишь одним из компонентов общей системы обработки: нейросетевая модель не классифицирует сигналы - она формирует латентное пространство (пространство представлений) на уровнях 1-3, а решение принимается на уровне геометрии этого пространства на уровнях 4-5.
Материалы и методы
В исследовании использовался подготовленный датасет, содержащий результаты радиотехнического наблюдения 14 источников радиосигналов (рис. 2):
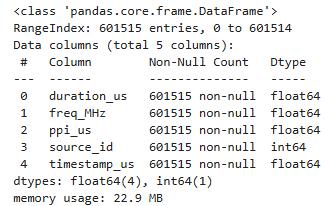
Рис 2. Характеристики используемого в исследовании датасета
Fig. 2. Characteristics of the dataset used in the study
В процессе подготовки данных для нейросетевой модели были сгенерированы дополнительные производные признаки, что увеличило их количество до 6, после чего данные были отмасштабированы (RobustScaler). Длина «скользящего окна» (T) выбрана равной 50, длина эмбеддинга – 32, значения выбраны эмпирически.
Нейросеть обучалась в два этапа: сперва обучалась базовая модель (base_model), состоящая из двух сверточных слоев, одного рекуррентного и одного полносвязного (выход - 14 нейронов по числу классов в исходном датасете), потом гибридная модель (rbf_model) - два сверточных, рекуррентный, полносвязный, радиально-базисный и полносвязный слои (также 14 нейронов по числу классов). Функция потерь (loss) - sparse_categorical_crossentropy. Центры радиально-базисных функций инициализируются с помощью алгоритма K-Means на тренировочных данных и далее уточняются в процессе обучения RBF-слоя посредством градиентного обновления. Финальная нейросетевая модель (final_emb_model) представляет собой обученную нейросеть без радиально-базисного и последнего полносвязного слоев (табл. 1).
Алгоритм формирования финальной нейросетевой модели (экстрактора эмбеддингов) следующий:
- Базовая модель обучается создавать эмбеддинги.
- Формируются центроиды для RBF-слоя и ими инициализируется RBF-слой.
- Формируется гибридная модель: удаляется полносвязный слой из базовой модели, добавляется RBF-слой, после опять полносвязный.
- Обучается гибридная модель (в процессе обучения «подтягиваются» градиенты, чтобы эмбеддинги «тянулись» к центроидам, которые тоже корректируются в процессе обучения RBF-слоя).
- Финальная модель – удаляются полносвязный и RBF-слои (по факту, архитектура базовой модели, полносвязный слой которой выдает эмбеддинги).
Таблица 1 / Table 1
Архитектура нейросетевых моделей в эксперименте
Architecture of neural network models in the experiment
|
Name model |
Layer (type) |
Output Shape |
Param # |
|
base_model |
input (InputLayer) |
(None, 50, 6) |
0 |
|
conv1 (Conv1D) |
(None, 48, 32) |
608 |
|
|
conv2 (Conv1D) |
(None, 46, 32) |
3104 |
|
|
lstm_core (LSTM) |
(None, 32) |
8320 |
|
|
fingerprint (Dense) |
(None, 32) |
1056 |
|
|
final_out (Dense) |
(None, 14) |
462 |
|
|
rbf_model |
input (InputLayer) |
(None, 50, 6) |
0 |
|
conv1 (Conv1D) |
(None, 48, 32) |
608 |
|
|
conv2 (Conv1D) |
(None, 46, 32) |
3104 |
|
|
lstm_core (LSTM) |
(None, 32) |
8320 |
|
|
fingerprint (Dense) |
(None, 32) |
1056 |
|
|
rbf_layer (RBFLayer) |
(None, 84) |
2772 |
|
|
final_out (Dense) |
(None, 14) |
1190 |
|
|
final_emb_model |
input (InputLayer) |
(None, 50, 6) |
0 |
|
conv1 (Conv1D) |
(None, 48, 32) |
608 |
|
|
conv2 (Conv1D) |
(None, 46, 32) |
3104 |
|
|
lstm_core (LSTM) |
(None, 32) |
8320 |
|
|
fingerprint (Dense) |
(None, 32) |
1056 |
Следует отметить, что в представленной архитектуре обучение нейросетевого энкодера выполняется с использованием функции потерь sparse_categorical_crossentropy, что соответствует стандартной классификационной постановке задачи. Однако в данном случае эта функция используется исключительно как механизм формирования структурированного латентного пространства. Классификационный слой присутствует только на этапе обучения и обеспечивает распространение градиентов, стимулирующих разделение эмбеддингов различных источников. После завершения обучения этот слой удаляется, а нейросеть используется исключительно как экстрактор эмбеддингов. Таким образом, итоговая система идентификации не является вероятностным классификатором, а функционирует как метрическая модель, в которой решение принимается на основе расстояний между эмбеддингами и прототипами источников.
Массив прототипов(эталонов) формируется как средние нормализованные эмбеддинги (18), полученные на тренировочной выборке с помощью финальной модели.
Механизм обнаружения неизвестных классов базируется на анализе удаленности эмбеддингов от эталонных прототипов. Для точной настройки порога неизвестности в валидационную выборку вносится аддитивный белый шум - такая калибровка имитирует неопределенность среды и позволяет системе корректно классифицировать аномалии в условиях отсутствия реальных примеров "чужих" данных.
Метрики: точность (precision), полнота (recall), F1-мера (f1-score) и матрица ошибок (confusion_matrix), поскольку она позволяет сразу оценить качество работы модели.
Визуальная оценка формирования кластеров эмбеддингов в латентном пространстве выполнялась с использованием алгоритма понижения размерности t-SNE, при этом следует понимать, что данная визуализация носит иллюстративный характер и применяется для качественной интерпретации структуры латентного пространства, тогда как количественная оценка качества идентификации выполняется на основе классификационных метрик и анализа матрицы ошибок.
Разработка и анализ результатов проводились с использованием платформы Jupyter Notebook, язык программирования Python 3.13, библиотеки и фреймворки – numpy, pandas, matplotlib, seaborn, scikit-learn, tensorflow. Радиально-базисный слой (class RBFLayer) и сопутствующие функции кастомные и реализованы отдельными классами и модулями (Изотов, Паняев 2026а; Изотов, Паняев 2026б; Изотов, Паняев 2026в).
Результаты
На рисунке 3 приведен классификационный отчет по результатам оценки качества финальной модели идентификации сигналов по классам на валидационной выборке. Из отчета прослеживается, что по всем классам precision на достаточно высоком уровне, а вот recall по отдельным классам «хромает». Значения метрики f1-score для большинства классов находятся на высоком уровне, за исключением классов 5 и 8 (в расчетах и на рисунке нумерация классов смещена на единицу вниз, «-1» – неизвестный источник).
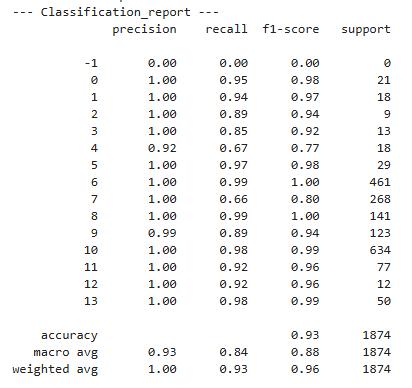
Рис. 3. Классификационный отчет оценки качества финальной модели на валидационной выборке
Fig. 3. Classification report for assessing the quality of the final model on the validation set
На рисунке 4 приведена матрица ошибок, рассчитанная на валидационной выборке, из которой следует, что большинство классов сигналов корректно идентифицируются моделью, за исключением классов 5 и 8, при этом модель практически не «путает» классы между собой, а нераспознанные эмбеддинги классов 5 и 8 относит к классу «unknown».
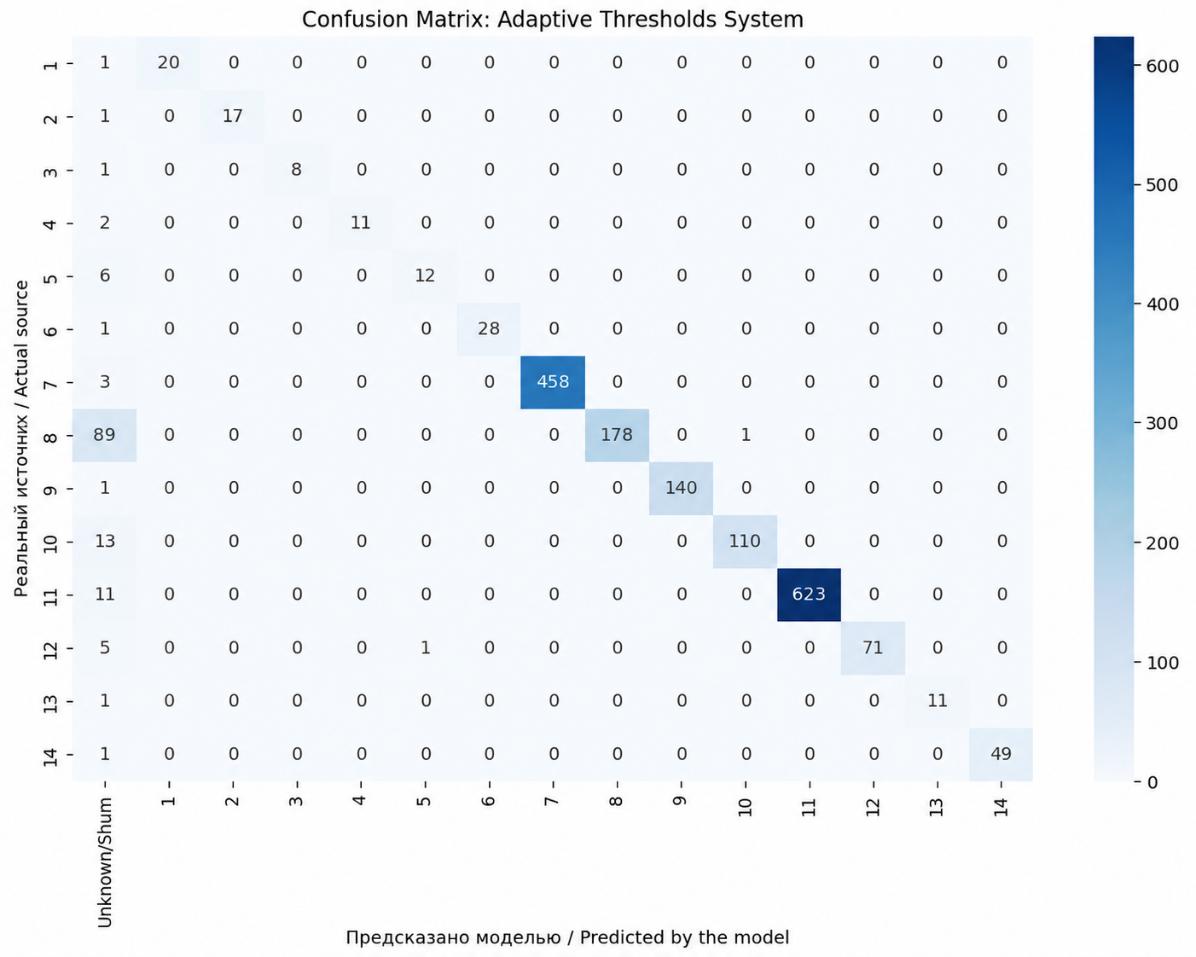
Рис 4. Матрица ошибок оценки качества финальной модели на валидационной выборке
Fig. 4. Confusion matrix for estimating the quality of the final model on the validation sample
На рисунке 5 приведена визуализация распределения эмбеддингов в латентном пространстве в процессе обучения базовой модели по эпохам, полученная с помощью алгоритма понижения размерности t-SNE. На этом рисунке хорошо прослеживается, как в процессе обучения формируются и уплотняются кластеры по классам.
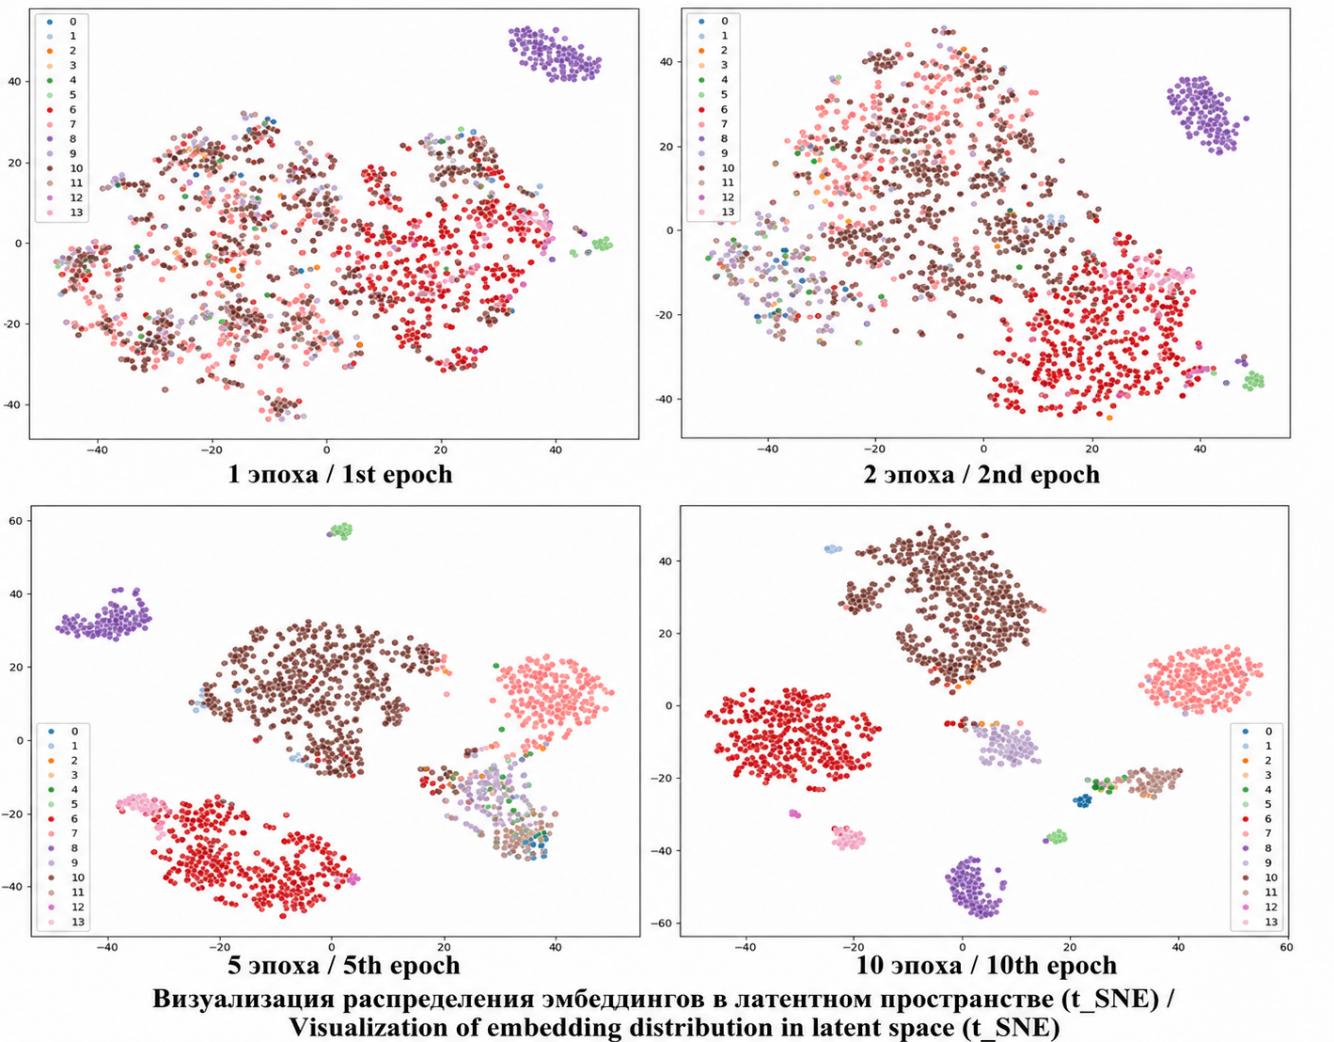
Рис 5. Визуализация латентного пространства с помощью алгоритма t-SNE в процессе обучения базовой модели
Fig. 5. Visualization of the latent space using the t-SNE algorithm during baseline model training
На рисунке 6 приведена визуализация распределения эмбеддингов в латентном пространстве на валидационной выборке по результатам работы финальной модели, причем на этом рисунке отображены и прототипы. Хорошо видно, что кластеры плотные, далеко разнесены в пространстве, что гарантирует достаточно уверенную идентификацию источника радиосигнала.
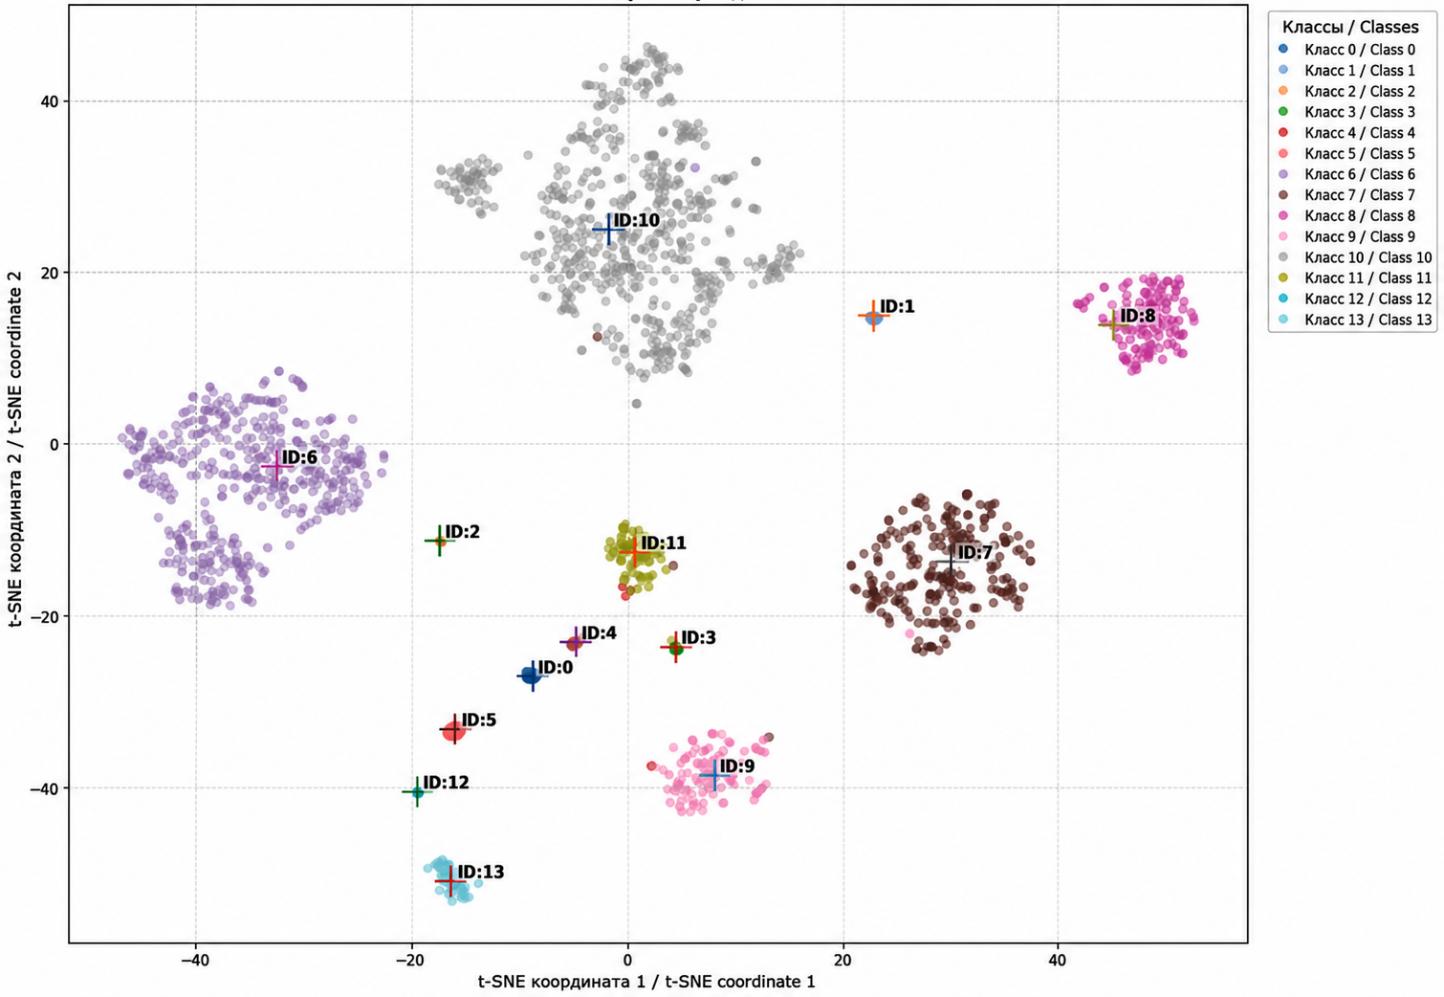
Рис. 6. Визуализация латентного пространства (финальная модель) с помощью алгоритма t-SNE
Fig. 6. Visualization of the latent space (final model) using the t-SNE algorithm
Обсуждение результатов
Полученные в работе результаты в целом подтверждают выдвинутую гипотезу о том, что использование радиально-базисного структурирования латентного пространства способствует формированию метрически упорядоченных эмбеддингов и повышает качество идентификации сигналов в условиях открытого множества. Проведённые эксперименты показали, что формируемые нейросетевой моделью эмбеддинги образуют устойчивые и хорошо разделённые кластеры, соответствующие отдельным источникам радиосигналов, что подтверждается как значениями классификационных метрик (рис. 3), так и визуализацией латентного пространства (рис. 5, 6).
Анализ матрицы ошибок (рис. 4) показывает, что система демонстрирует достаточно высокое качество идентификации по большинству классов, при этом ошибки преимущественно проявляются не в виде смешения классов между собой, а в форме отнесения отдельных эмбеддингов к классу «unknown». Такая структура ошибок является характерной для систем распознавания открытого множества и свидетельствует о корректной работе порогового механизма выявления неизвестных источников. Фактически модель демонстрирует консервативную стратегию принятия решений, предпочитая отнести сигнал к категории неизвестных, нежели ошибочно идентифицировать его как один из известных источников.
Отдельные сложности идентификации наблюдаются для классов 5 и 8 (рис. 3, 4), что проявляется в снижении показателей полноты (recall). Данный эффект может быть связан с меньшей внутриклассовой устойчивостью временных паттернов этих источников либо с их частичным перекрытием в пространстве признаков. Тем не менее даже в этих случаях система не демонстрирует значимого смешения классов, что подтверждает корректность геометрической организации латентного пространства и устойчивость выбранного метрического критерия.
Визуальный анализ распределения эмбеддингов (рис. 5, 6) показывает, что в процессе обучения происходит постепенное уплотнение кластеров и увеличение расстояний между ними. Это косвенно подтверждает роль радиально-базисного слоя как механизма структурирования латентного пространства. Градиенты, распространяемые от RBF-слоя, стимулируют формирование компактных гиперсфер вокруг центроидов, что приводит к появлению устойчивых областей притяжения для эмбеддингов сигналов одного источника. В результате формируется геометрически интерпретируемая структура пространства признаков, в которой расстояние между точками напрямую отражает степень сходства источников сигналов.
Полученные результаты согласуются с современными исследованиями в области метрического обучения и идентификационных систем, где ключевую роль играет не сама процедура классификации, а формирование устойчивых признаковых представлений объектов (Geng et al., 2021; Oza, Patel, 2019; Schroff et al., 2015). В отличие от традиционных нейросетевых классификаторов с функцией softmax, предложенный архитектурный подход переносит основную логику распознавания в пространство расстояний между эмбеддингами, что обеспечивает более высокую гибкость системы при работе с неполными априорными знаниями.
Важным практическим следствием предлагаемой архитектуры является возможность независимой модификации базы эталонных прототипов без изменения самой нейросетевой модели. Поскольку идентификация осуществляется на основе расстояния между эмбеддингом и набором центроидов, то добавление новых источников сигналов может осуществляться путем включения новых прототипов в эталонную базу. Это позволяет существенно снизить вычислительные затраты на адаптацию системы и делает предложенный подход перспективным для широкого круга задач и анализа динамически изменяющихся сред, таких как радиочастотные.
Таким образом, результаты экспериментов демонстрируют, что разделение процессов формирования признакового пространства и принятия решения, а также использование радиально-базисного структурирования латентного пространства являются эффективными архитектурными принципами построения систем идентификации сигналов, функционирующих в условиях открытого множества.
Заключение
В работе предложен архитектурный подход к построению систем идентификации источников сигналов, основанный на разделении процессов формирования признакового представления и принятия решения. В отличие от традиционных нейросетевых классификаторов, в которых нейронная сеть одновременно выполняет извлечение признаков и классификацию, предложенная архитектура рассматривает нейросетевую модель как инструмент формирования латентного пространства признаковых представлений, тогда как процедура идентификации реализуется на основе анализа геометрических отношений между эмбеддингами.
Показано, что использование последовательностного энкодера на основе сверточных и рекуррентных слоев позволяет эффективно моделировать временную структуру сигнальных процессов и формировать компактные эмбеддинги, отражающие устойчивые характеристики источников радиосигналов. Дополнительное структурирование латентного пространства с использованием радиально-базисного слоя способствует формированию метрически упорядоченных кластеров эмбеддингов, что повышает устойчивость системы к вариациям сигналов и улучшает разделимость различных источников.
Результаты экспериментального исследования на датасете, содержащем сигналы 14 источников, показали, что предложенная архитектура обеспечивает высокую точность идентификации известных источников при одновременной способности корректно выявлять сигналы неизвестного происхождения. При этом характер ошибок модели свидетельствует о том, что система преимущественно избегает смешения классов, относя неоднозначные сигналы к категории неизвестных, что соответствует требованиям систем распознавания, функционирующих в условиях открытого множества.
Важным преимуществом предложенного подхода является возможность независимого развития базы эталонных прототипов без необходимости повторного обучения нейросетевой модели. Поскольку идентификация осуществляется на основе расстояний между эмбеддингами и центроидами, добавление новых источников может быть реализовано путем расширения набора прототипов в латентном пространстве. Это делает систему более гибкой и позволяет адаптировать её к изменяющимся условиям среды.
Полученные результаты подтверждают перспективность метрического подхода к построению систем идентификации временных сигналов и демонстрируют его применимость для задач анализа радиочастотных источников в условиях неполных априорных знаний. В дальнейшем представляется целесообразным исследовать влияние размерности латентного пространства, структуры последовательностного энкодера и способов формирования прототипов на устойчивость системы, а также рассмотреть возможность применения предложенной архитектуры к другим типам временных данных, например, телеметрические и акустические сигналы.
Предложенная концепция разделения процессов формирования признаков и принятия решений позволяет системе сохранять вычислительную эффективность нейросетевых методов, обеспечивая при этом гибкость и интерпретируемость классических метрических подходов. Это открывает путь к созданию динамически пополняемых баз эталонов сигналов без необходимости повторного обучения нейронной сети при появлении новых источников.
Ограничения. Несмотря на полученные положительные результаты, предложенный подход имеет ряд ограничений, которые необходимо учитывать при интерпретации результатов. В первую очередь следует отметить, что проведённое исследование выполнено на ограниченном наборе источников радиосигналов. Хотя полученные результаты демонстрируют устойчивое формирование кластеров эмбеддингов и высокую точность идентификации, при существенном увеличении количества источников и усложнении радиочастотной среды структура латентного пространства может становиться более сложной и требовать дополнительной оптимизации архитектуры модели.
Вторым ограничением является зависимость работы системы от параметров формирования последовательностей сигналов, прежде всего длины «скользящего окна» и набора используемых признаков. Выбранные в работе параметры обеспечивают корректное моделирование временной структуры сигналов в рамках используемого датасета, однако при применении метода к другим типам сигналов или иным режимам работы источников может потребоваться дополнительная адаптация параметров последовательностного представления.
Также следует отметить, что механизм выявления неизвестных источников в предложенной архитектуре основан на пороговом контроле расстояния между эмбеддингами и эталонными прототипами. Эффективность такого подхода во многом определяется корректностью выбора порога неизвестности. В настоящей работе его калибровка осуществлялась с использованием искусственного аддитивного шума, что позволяет имитировать неопределённость среды, однако в реальных условиях распределение неизвестных сигналов может отличаться от используемой модели шума.
Указанные ограничения определяют направления дальнейших исследований, связанных с масштабированием архитектуры на более сложные среды, разработкой более адаптивных механизмов обнаружения неизвестных источников и исследованием устойчивости латентных представлений при изменении структуры входных данных.
Limitations. Despite the positive results obtained, the proposed approach has a number of limitations that must be considered when interpreting the results. First and foremost, it should be noted that the study was conducted on a limited set of radio signal sources. While the results demonstrate stable formation of embedding clusters and high identification accuracy, with a significant increase in the number of sources and a more complex radio frequency environment, the latent space structure may become more complex and require further optimization of the model architecture.
A second limitation is the dependence of the system's operation on the parameters for generating signal sequences, primarily the length of the sliding window and the set of features used. The parameters chosen in this study ensure correct modeling of the temporal structure of signals within the dataset used. However, when applying the method to other signal types or other source operating modes, additional adaptation of the sequential representation parameters may be necessary.
It should also be noted that the mechanism for identifying unknown sources in the proposed architecture is based on threshold control of the distance between embeddings and reference prototypes. The effectiveness of this approach is largely determined by the correct selection of the unknown threshold. In this paper, its calibration was performed using artificial additive noise, which simulates environmental uncertainty. However, in real-world conditions, the distribution of unknown signals may differ from the noise model used.
These limitations identify areas for further research related to scaling the architecture to more complex environments, developing more adaptive mechanisms for detecting unknown sources, and studying the stability of latent representations under changing input data structures.