Введение
Традиционно приближенные методы решения дифференциальных уравнений подразделяются на численные (методы Эйлера, Рунге–Кутты и др.) и аналитические (разложения в ряд Тейлора или Фурье, методы малого параметра и др.). Эти методы широко используются при построении моделей динамических систем, описываемых дифференциальными уравнениями. В конце XX века к приближенным аналитическим методам были отнесены и нейронные сети. В настоящее время данный подход получил развитие в рамках концепции Physics-Informed Neural Networks (PINN) — метода решения дифференциальных уравнений, сочетающего универсальность нейронных сетей с учетом физических законов (Antonov, Tarkhov, Vasilyev, 2018; Raissi, Perdikaris, Karniadakis, 2019; Tarkhov, Vasilyev, 2019; Vasilyev, Tarkhov, 2014).
Классические PINN аппроксимируют решение дифференциального уравнения с помощью нейронной сети, вычисляя необходимые производные через автоматическое дифференцирование и минимизируя остаток уравнения. Несмотря на успешное применение в различных областях, такой подход сопровождается значительными вычислительными затратами и часто обладает ограниченной интерпретируемостью результатов (Karniadakis et al., 2021).
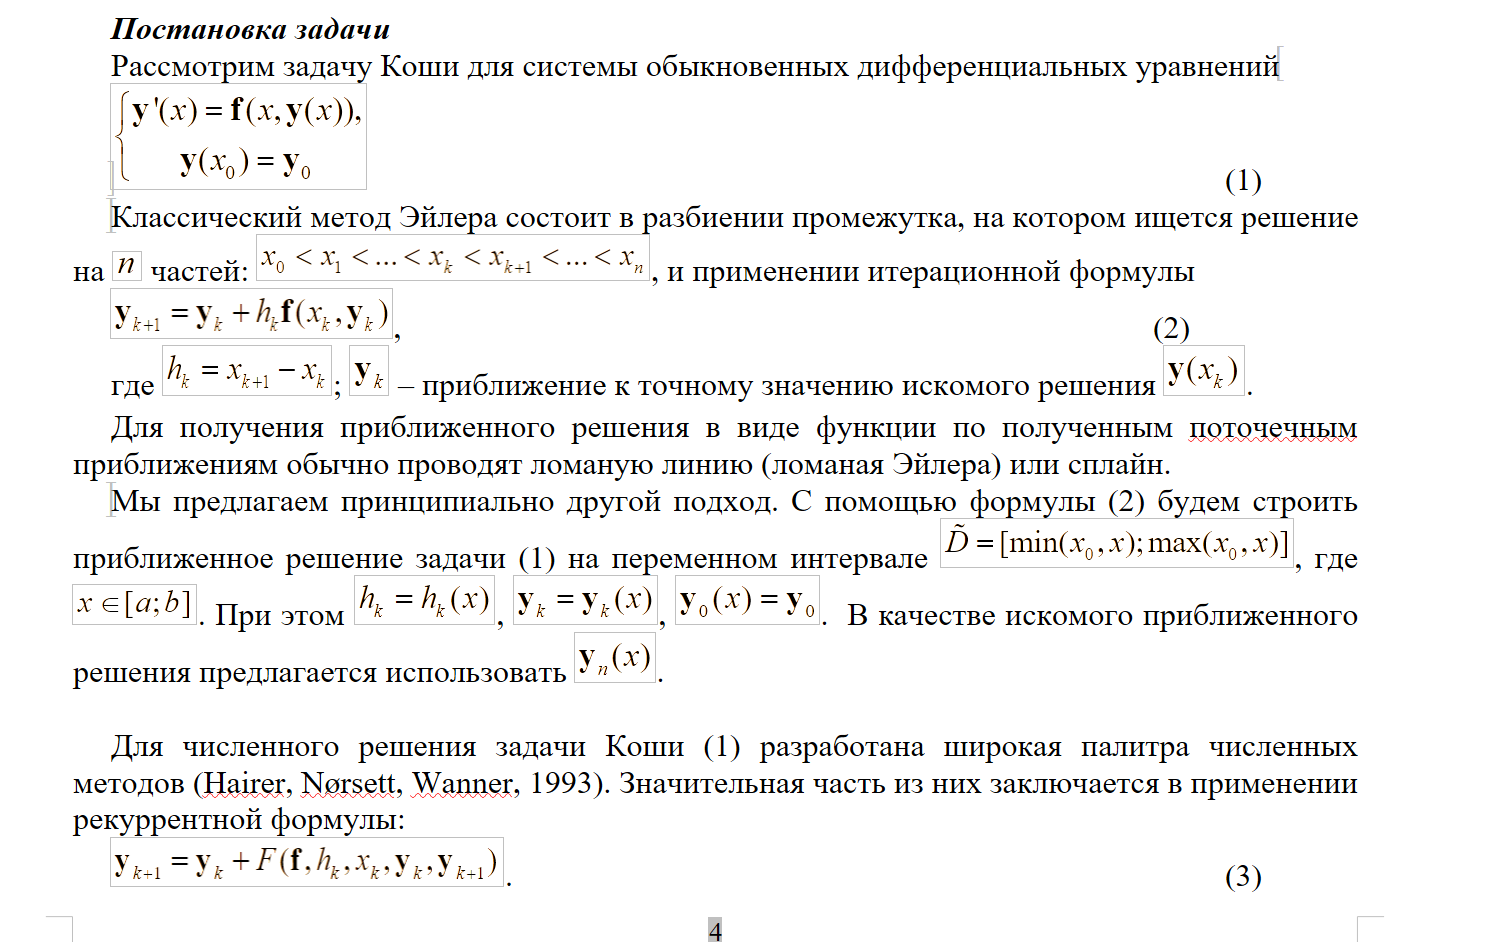
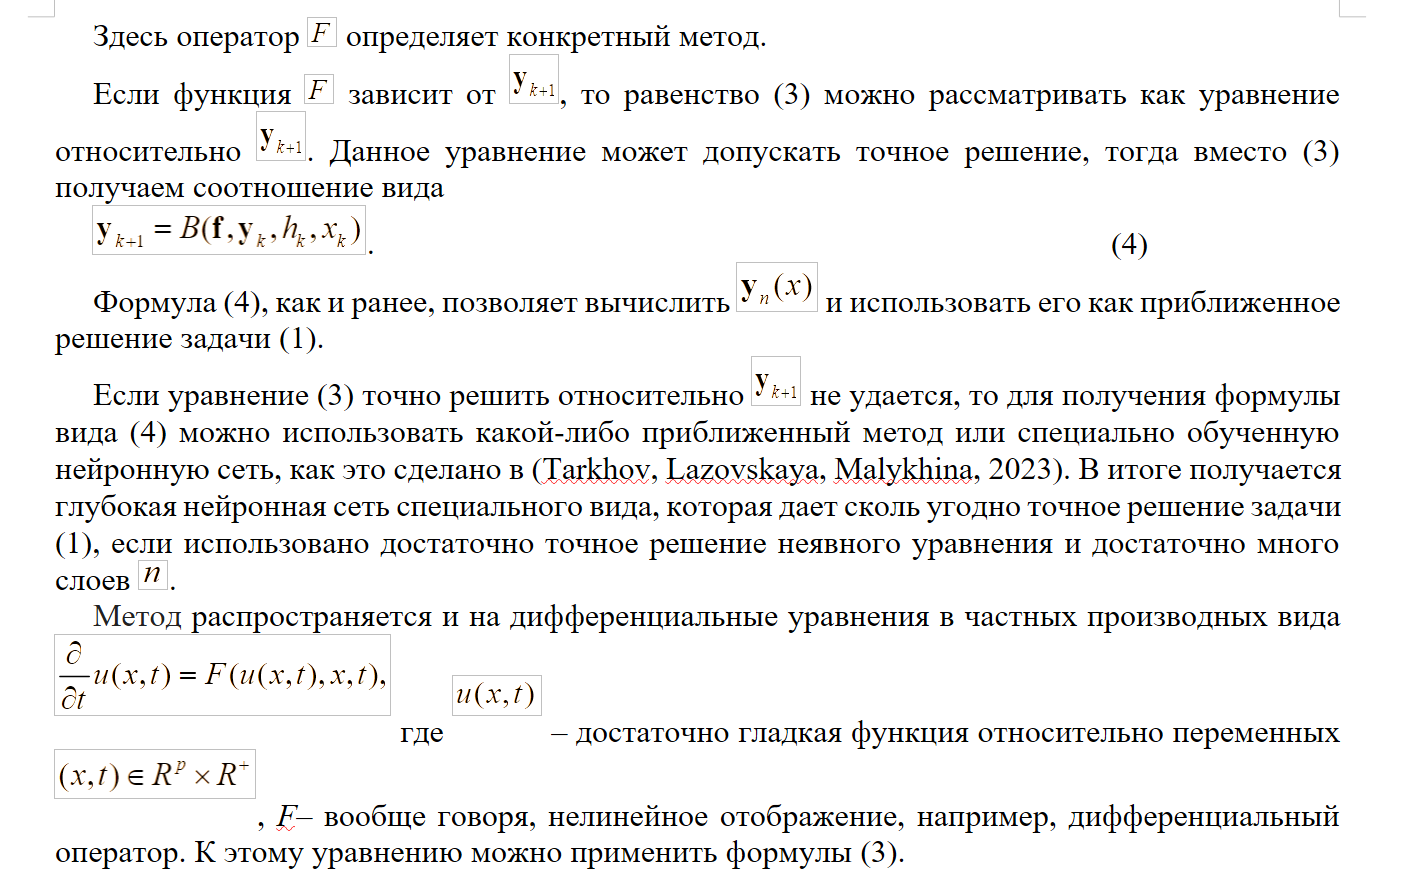
В последние годы было показано, что классические численные методы могут рассматриваться как аналитические при применении к интервалам переменной длины (Lazovskaya, Tarkhov, 2016; Lazovskaya, Tarkhov, Vasilyev, 2018; Tarkhov, Vasilyev, 2019). Это позволяет по-новому интерпретировать связь между численными и аналитическими методами и использовать ее при построении нейросетевых моделей динамических систем. С этой точки зрения особый интерес представляет концепция многоуровневого моделирования (multi-fidelity modeling), предполагающая использование упрощенных моделей (low-fidelity) для эффективного исследования пространства решений с последующим уточнением результатов с помощью более точных, но вычислительно затратных моделей (high-fidelity) (Cuomo et al., 2022; Jagtap, Kawaguchi, Karniadakis, 2020; Peherstorfer, 2019; Penwarden et al., 2022; Wang, Teng, Perdikaris, 2021).
Использование аналитической модификации численных методов (АМЧМ) с небольшим числом слоев модели (здесь и далее под слоем модели понимается шаг исходного численного метода) позволяет строить компактные модели уровня low-fidelity с приемлемой точностью. Переход к моделям уровня high-fidelity может быть реализован посредством интеграции численных методов непосредственно в архитектуру нейронных сетей (Lazovskaya, Tarkhov, 2026; Tarkhov, Lazovskaya, Malykhina, 2023). Это позволяет существенно сократить число обучаемых параметров и повысить интерпретируемость модели (Tarkhov, Lazovskaya, Malykhina, 2023).
Настоящая работа развивает подход, предложенный в (Lazovskaya, Tarkhov, 2026; Tarkhov, Lazovskaya, Malykhina, 2023), путем построения архитектуры LF-PINN, основанной на обобщенном методе трапеций с адаптивным параметром θ. Компактная параметрическая сеть, подставленная в схему вместо θ автоматически выбирает баланс между явной и неявной схемами для различных точек пространственно-временной области, адаптируясь к локальным особенностям решения и обеспечивая построение эффективных моделей динамических систем.
Целью исследования является демонстрация того, что интеграция численных методов в архитектуру PINN позволяет существенно ускорить обучение при сохранении сопоставимой или более высокой точности моделирования по сравнению с классическим подходом. Дальнейшее повышение точности модели может быть достигнуто за счет увеличения размера используемой нейронной сети.
Материалы и методы
Адаптивная θ-схема
В работе в качестве (3) рассматривается обобщенная θ-схема, которая представляет собой взвешенную комбинацию явного и неявного методов Эйлера:
где h - размер временного шага, θ - параметр схемы. Различные значения θ соответствуют различным численным методам:
-
•θ = 0 — явный метод Эйлера
-
•θ = 0,5 — метод трапеций
-
•θ = 1 — неявный метод Эйлера
В LF-PINN параметр θ не является константой, а адаптивно вычисляется θ-net для каждой точки пространственно-временной области. Это позволяет модели локально балансировать между устойчивостью (высокие значения θ → неявная схема) и вычислительной эффективностью (низкие значения θ → явная схема). Например, в областях с крутыми градиентами модель может автоматически увеличивать θ для повышения устойчивости.
θ-net представляет собой компактную нейронную сеть с одним скрытым слоем, которая определяет тип численной схемы для каждой точки пространственно-временной области:
Где
где σ — сигмоидальная функция активации. Сеть имеет всего 13 обучаемых параметров и получает на вход четыре признака:
-
• - пространственная координата
-
• - текущее время
-
• - время следующего шага
-
• - нормализованная норма пространственного градиента текущего решения (позволяет адаптироваться к локальной жесткости задачи)
Компактность сети (13 параметров) критична для предотвращения переобучения и обеспечения обобщающей способности. Малое количество параметров гарантирует, что модель не будет «запоминать» решение, а будет учиться выбирать правильный тип численной схемы на основе локальных свойств задачи. В связи с этим данная сеть далее называется LF-PINN. При необходимости повысить точность можно нарастить размер сети или использовать отдельную сеть для каждого слоя.
Итерационное решение неявной части схемы
Например, для уравнения теплопроводности на каждой итерации необходимо:
-
•Вычислить через автоматическое дифференцирование
-
•Вычислить через повторное дифференцирование
-
•Получить f = α · и обновить решение
Функция потерь
Общая функция потерь LF-PINN включает те же три компонента, что и классическая PINN (Vasilyev, Tarkhov, 2014):
Результаты
Экспериментальные результаты показывают, что предложенная модель с 13 параметрами достигает точности, превосходящей или сопоставимой с классической PINN, имеющей в пять раз больше параметров. При этом наблюдаются существенные различия в поведении моделей в зависимости от типа уравнения. Сравнение проводилось в условиях фиксированного времени обучения (60 секунд), что отражает практические ограничения при получении решения за ограниченное время. Сводные результаты сравнения приведены в табл. 1.
Временной бюджет выбран на основании анализа кривых обучения: для всех рассматриваемых уравнений функция потерь обеих моделей выходит на плато в пределах отведенного времени. Дальнейшее увеличение бюджета не приводит к существенному улучшению точности ни одной из моделей. Таким образом, выбранные условия обеспечивают сходимость обеих моделей и корректность сравнения.
Таблица 1 / Table 1
Сравнительные результаты LF-PINN и Classical PINN для различных типов уравнений (среднее ± стандартное отклонение по 5 прогонам)
Comparative results of LF-PINN and Classical PINN for different equation types
(mean ± standard deviation over 5 runs)
|
Уравнение / Метод |
L2RE |
Epochs (μ±σ) |
|
Heat Equation |
|
|
|
LF-PINN |
1,65×10⁻² ± 1,1×10⁻³ |
366 ± 20 |
|
Classical PINN |
3,29×10⁻² ± 1,4×10⁻² |
82971 ± 2095 |
|
Wave Equation |
|
|
|
LF-PINN |
3,16×10⁻² ± 5,7×10⁻⁴ |
95 ± 6 |
|
Classical PINN |
4,05×10⁻² ± 1,2×10⁻² |
65385 ± 582 |
|
Reaction-Diffusion |
|
|
|
LF-PINN |
1,24×10⁻¹ ± 2,3×10⁻⁵ |
130 ± 8 |
|
Classical PINN |
1,24×10⁻¹ ± 7,2×10⁻⁴ |
79700 ± 2875 |
|
Burgers Equation |
|
|
|
LF-PINN |
1,62×10⁻¹ ± 1,4×10⁻³ |
150 ± 0 |
|
Classical PINN |
2,67×10⁻¹ ± 2,0×10⁻² |
82574 ± 295 |
Уравнение теплопроводности
LF-PINN продемонстрировала значительное превосходство с
L2RE = 1,65×10⁻² против 3,29×10⁻² у классической PINN (улучшение на 50%), как показано на рис. 1
Низкая дисперсия результатов (σ = 1,1×10⁻³ для LF-PINN против 1,4×10⁻² для Classical) указывает на большую устойчивость метода к выбору начальной инициализации.
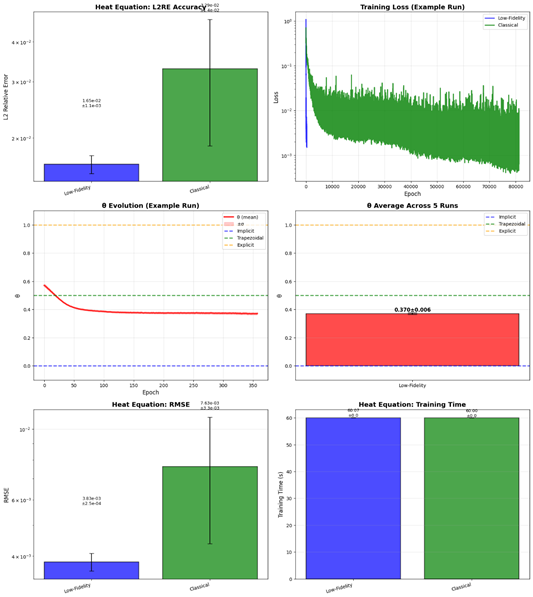
Рис. 1. Сравнение предложенного подхода (Low-Fidelity) с классическим методом на задаче уравнения теплопроводности. (a) Относительная ошибка L2RE. (b) Кривая обучения (Training Loss) для одного репрезентативного прогона. (c) Динамика параметра θ в ходе обучения. (d) Среднее значение θ по 5 запускам. (e) Ошибка RMSE. (f) Время обучения
Fig. 1. Comparison of the proposed approach (LF-PINN) and Classical PINN on the Heat equation. (a) L2 Relative Error. (b) Training loss curve for a single representative run. (c) Evolution of parameter θ during training. (d) Mean value of θ over 5 runs. (e) RMSE. (f) Training time
Волновое уравнение
Для волнового уравнения LF-PINN также показывает лучшую точность L2RE = 3,16×10⁻² против 4,05×10⁻², но разница менее выраженная, что видно на рис. 2.
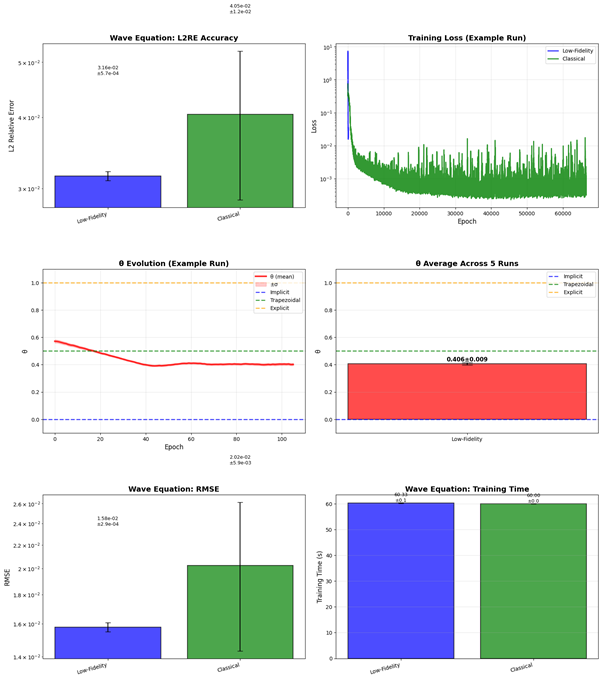
Рис. 2. Сравнение предложенного подхода (Low-Fidelity) с классическим методом на задаче волнового уравнения. (a) Относительная ошибка L2RE. (b) Кривая обучения (Training Loss) для одного репрезентативного прогона. (c) Динамика параметра θ в ходе обучения. (d) Среднее значение θ по 5 запускам. (e) Ошибка RMSE. (f) Время обучения
Fig. 2. Comparison of the proposed approach (LF-PINN) and Classical PINN on the Wave equation. (a) L2 Relative Error. (b) Training loss curve for a single representative run. (c) Evolution of parameter θ during training. (d) Mean value of θ over 5 runs. (e) RMSE. (f) Training time
Уравнение реакции-диффузии
На этой задаче, как иллюстрирует рис. 3, обе модели показали практически идентичное качество L2RE ≈ 1,24×10⁻¹.
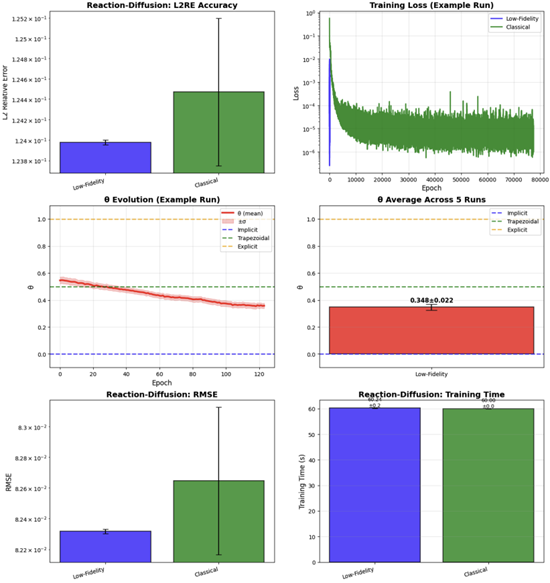
Рис. 3. Сравнение предложенного подхода (Low-Fidelity) с классическим методом на задаче уравнения Реакции-Диффузии. (a) Относительная ошибка L2RE. (b) Кривая обучения (Training Loss) для одного репрезентативного прогона. (c) Динамика параметра θ в ходе обучения. (d) Среднее значение θ по 5 запускам. (e) Ошибка RMSE. (f) Время обучения
Fig. 3. Comparison of the proposed approach (LF-PINN) and Classical PINN on the Reaction-Diffusion equation. (a) L2 Relative Error. (b) Training loss curve for a single representative run. (c) Evolution of parameter θ during training. (d) Mean value of θ over 5 runs. (e) RMSE. (f) Training time
Уравнение Бюргерса
На наиболее сложной задаче с сильной нелинейностью (Jagtap, Kawaguchi, Karniadakis, 2020) LF-PINN снова превосходит классический подход: L2RE = 1,62×10⁻¹ против 2,67×10⁻¹ (улучшение на 39%), как демонстрирует рис. 4.
Нелинейный конвективный член u·∂u/∂x создает формирование ударных волн и требует особенно аккуратного численного подхода (Cuomo et al., 2022; Jagtap, Kawaguchi, Karniadakis, 2020). Адаптивный выбор схемы через θ-net позволяет LF-PINN эффективно справляться с этими особенностями.
Интересно, что среднее значение θ ≈ 0,20 — наименьшее среди четырех рассмотренных задач — показывает предпочтение более явных схем.

Рис. 4. Сравнение предложенного подхода (Low-Fidelity) с классическим методом на задаче уравнения Бюргерса. (a) Относительная ошибка L2RE. (b) Кривая обучения (Training Loss) для одного репрезентативного прогона. (c) Динамика параметра θ в ходе обучения. (d) Среднее значение θ по 5 запускам. (e) Ошибка RMSE. (f) Время обучения
Fig. 4. Comparison of the proposed approach (LF-PINN) and Classical PINN on Burgers equation. (a) L2 Relative Error. (b) Training loss curve for a single representative run. (c) Evolution of parameter θ during training. (d) Mean value of θ over 5 runs. (e) RMSE. (f) Training time
Обсуждение результатов
Ключевое преимущество LF-PINN заключается в том, что высокая точность достигается при малом числе параметров. В проведенных экспериментах даже компактная архитектура (один скрытый слой с 2 нейронами) обеспечивает качество, сопоставимое или превосходящее классические PINN (Antonov, Tarkhov, Vasilyev, 2018; Raissi, Perdikaris, Karniadakis, 2019; Tarkhov, Vasilyev, 2019; Vasilyev, Tarkhov, 2014), требующие существенно большего числа параметров, что обусловлено использованием встроенной численной схемы.
Важным наблюдением является значительно меньшая дисперсия результатов для LF-PINN по сравнению с классической моделью (Antonov, Tarkhov, Vasilyev, 2018; Raissi, Perdikaris, Karniadakis, 2019; Tarkhov, Vasilyev, 2019; Vasilyev, Tarkhov, 2014). Это указывает на то, что архитектура LF-PINN более устойчива к выбору начальной инициализации весов и менее подвержена попаданию в локальные минимумы. Стандартное отклонение L2RE для LF-PINN в среднем на порядок меньше, чем для классической PINN.
Адаптивность параметра θ демонстрируется его изменением в зависимости от типа уравнения и локальных свойств решения. Для уравнения теплопроводности среднее значение θ = 0,37, что ближе к методу трапеций и обеспечивает баланс между точностью и устойчивостью. Для волнового уравнения θ = 0,41, для уравнения реакции-диффузии θ = 0,35, а для уравнения Бюргерса θ = 0,20, что свидетельствует о предпочтении более явных методов. Эта адаптивность является ключевым преимуществом подхода, так как не требует ручной настройки численной схемы для каждого типа уравнения. Сводное сравнение относительной ошибки по всем четырем типам уравнений приведено на рис. 5.
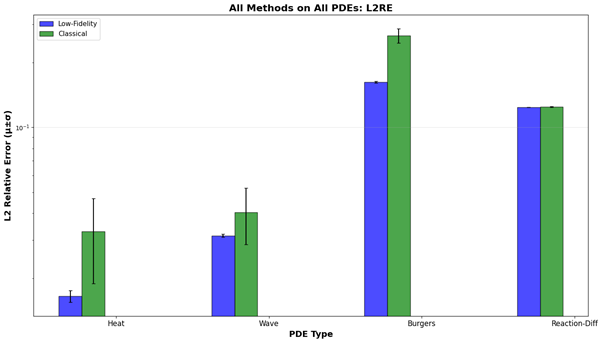
Рис. 5. Сравнение относительной ошибки L2RE (µ ± σ по 5 запускам) предложенного Low-Fidelity метода с классической реализацией PINN на четырех типах уравнений в частных производных
Fig. 5. Comparison of L2 Relative Error (µ ± σ over 5 runs) between the proposed Low-Fidelity PINN and Classical PINN across four types of partial differential equations
Заключение
Разработанная архитектура LF-PINN (Lazovskaya, Tarkhov, 2026; Tarkhov, Lazovskaya, Malykhina, 2023) демонстрирует ряд существенных преимуществ по сравнению с классическими PINN (Antonov, Tarkhov, Vasilyev, 2018; Raissi, Perdikaris, Karniadakis, 2019; Tarkhov, Vasilyev, 2019; Vasilyev, Tarkhov, 2014):
-
•Вычислительная эффективность. Интеграция численной схемы непосредственно в архитектуру нейронной сети позволяет избежать многократного вычисления производных высокого порядка через автоматическое дифференцирование. Предложенная модель требует существенно меньшего числа эпох для сходимости - от 95 до 366 против 65 000—83 000 у классической PINN, что делает метод практически применимым для реальных задач.
-
•Адаптивность. Параметрическая сеть θ-net автоматически выбирает оптимальный баланс между явной и неявной схемами для каждой точки пространственно-временной области (Lazovskaya, Tarkhov, 2026). Это позволяет модели адаптироваться к локальным особенностям решения, таким как крутые градиенты или осцилляции. В отличие от традиционных численных методов, где выбор схемы делается вручную и фиксируется на всю область, LF-PINN может использовать различные схемы в различных частях области.
-
•Компактность модели. Использование всего 13 параметров в θ-net предотвращает переобучение и обеспечивает хорошую обобщающую способность. В отличие от классической PINN, которая требует глубоких сетей с десятками или сотнями параметров (Karniadakis et al., 2021; Raissi, Perdikaris, Karniadakis, 2019), LF-PINN полагается на встроенную физическую информацию через численную схему (Lazovskaya, Tarkhov, 2026; Tarkhov, Lazovskaya, Malykhina, 2023). Это также упрощает интерпретацию модели: вместо изучения сложного нелинейного отображения, θ-net учится только выбору оптимальной численной схемы.
-
•Устойчивость обучения. Значительно меньшая дисперсия результатов по сравнению с классической PINN указывает на то, что метод менее чувствителен к инициализации и гиперпараметрам. Это критически важно для практического применения, где требуется воспроизводимость результатов. В экспериментах стандартное отклонение L2RE для LF-PINN составляло 10⁻⁵—10⁻³, в то время как для классической PINN 10⁻³—10⁻², что на 1—2 порядка выше.
Рассмотренные LF-PINN удобно использовать для суррогатного моделирования (Jiang, Zhou, Shao, 2020; Manzoni et al., 2020; Ranftl, von der Linden, 2021; Zhou, Mei, Xu, 2023)